<?xml version="1.0" encoding="utf-8"?> 
<feed xmlns="http://www.w3.org/2005/Atom" xml:lang="en-us">
    <generator uri="https://gohugo.io/" version="0.141.0">Hugo</generator><title type="html"><![CDATA[Performance on Blog]]></title>


            <link href="https://blog.scientific-python.org/tags/performance/" rel="alternate" type="text/html" title="html" />
            <link href="https://blog.scientific-python.org/tags/performance/atom.xml" rel="self" type="application/atom" title="atom" />
    <updated>2026-10-07T03:43:58+00:00</updated>


        <id>https://blog.scientific-python.org/tags/performance/</id>
    
        
        <entry>
            <title type="html"><![CDATA[Finding Another Layer of Performance in np.searchsorted]]></title>
            <link href="https://blog.scientific-python.org/numpy/finding-another-layer-of-performance-in-np-searchsorted/?utm_source=atom_feed" rel="alternate" type="text/html" />
            
                <link href="https://blog.scientific-python.org/numpy/searchsorted/?utm_source=atom_feed" rel="related" type="text/html" title="Making np.searchsorted up to 25× Faster in NumPy 2.5" />
                <link href="https://blog.scientific-python.org/numpy/fellowship-program-2025-retrospective/?utm_source=atom_feed" rel="related" type="text/html" title="A Year of Typing: My NumPy Fellowship Retrospective" />
                <link href="https://blog.scientific-python.org/numpy/fellowship-program-2025/?utm_source=atom_feed" rel="related" type="text/html" title="NumPy&#39;s Second Developer in Residence: Joren Hammudoglu" />
                <link href="https://blog.scientific-python.org/numpy/numpy2/?utm_source=atom_feed" rel="related" type="text/html" title="NumPy 2.0: an evolutionary milestone" />
                <link href="https://blog.scientific-python.org/numpy/numpy-rng/?utm_source=atom_feed" rel="related" type="text/html" title="Best Practices for Using NumPy&#39;s Random Number Generators" />
            
                <id>https://blog.scientific-python.org/numpy/finding-another-layer-of-performance-in-np-searchsorted/</id>
            
            
            <published>2026-10-07T09:11:00+09:00</published>
            <updated>2026-10-07T09:11:00+09:00</updated>
            
            
            <content type="html"><![CDATA[<blockquote>A performance investigation into reusing insertion-position locality in NumPy searchsorted, and why reducing work can complement CPU-friendly batched execution.</blockquote><p>I did not start from <code>np.searchsorted</code>.</p>
<p>The idea came from a broader question I had been exploring in my own infrastructure work:</p>
<p><strong>Has the system already paid for information that we are about to compute again?</strong></p>
<p>In my <a href="https://github.com/Johnny-Kao/CoreFoundry-Project">CoreFoundry project</a>, one recurring principle was simple: before adding more hardware or parallelism, first remove work that never needed to happen.</p>
<p>That same question eventually led me to <code>np.searchsorted</code>.</p>
<h2 id="reusing-information-that-already-exists">Reusing information that already exists<a class="headerlink" href="#reusing-information-that-already-exists" title="Link to this heading">#</a></h2>
<p><code>np.searchsorted</code> finds insertion positions in a sorted array.</p>
<p>Conceptually, every query can begin with the entire search space:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl">0                                                     N
</span></span><span class="line"><span class="cl">|-----------------------------------------------------|</span></span></code></pre>
</div>
<p>But suppose several nearby queries produce insertion positions like:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl">500000
</span></span><span class="line"><span class="cl">500004
</span></span><span class="line"><span class="cl">500009
</span></span><span class="line"><span class="cl">500013
</span></span><span class="line"><span class="cl">500018</span></span></code></pre>
</div>
<p>After the first search, the next one is no longer starting with zero information.</p>
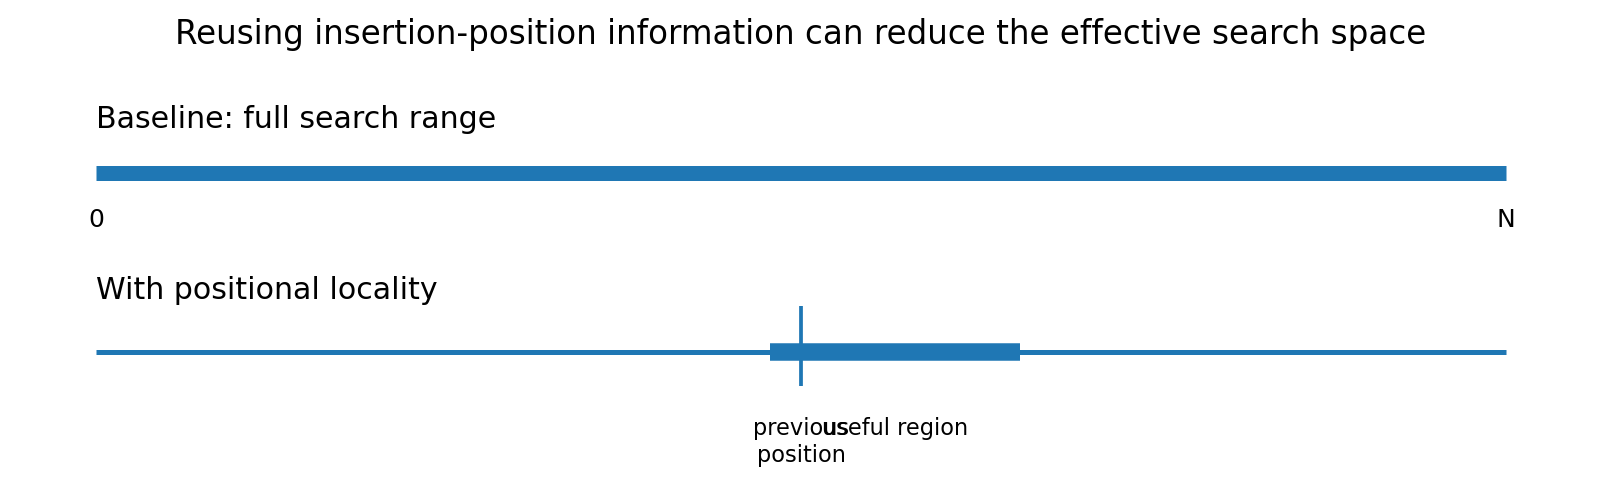
<p>The previous insertion position is not only an output. When the workload has positional locality, it also contains information about where the next search is likely to land.</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl">0                         p                           N
</span></span><span class="line"><span class="cl">|-------------------------|---------------------------|
</span></span><span class="line"><span class="cl">                          [---- useful region ----]</span></span></code></pre>
</div>
<p>That became the basic idea of the experiment: reuse information already produced by the search to reduce the amount of subsequent search work.</p>
<p>There was one important constraint.</p>
<p>Detecting locality should not require another full pass over the query array. An additional $O(Q)$ scan just to decide whether an optimization should run could easily consume the performance benefit.</p>
<p>Instead, the implementation uses intermediate position information already produced by the existing batched search.</p>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/search-space-reduction.png" alt="Comparison between a full search range and a smaller useful search region around a previous insertion position."></p>
<p><em>Figure 1. Positional locality can reduce the effective search space without adding a separate scan of the query array.</em></p>
<h2 id="knowing-when-to-use-it">Knowing when to use it<a class="headerlink" href="#knowing-when-to-use-it" title="Link to this heading">#</a></h2>
<p>The optimization itself was relatively simple.</p>
<p>Deciding when to use it was harder.</p>
<p>Compare these two workloads:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl">Strong locality
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">100001
</span></span><span class="line"><span class="cl">100004
</span></span><span class="line"><span class="cl">100009
</span></span><span class="line"><span class="cl">100013
</span></span><span class="line"><span class="cl">100018</span></span></code></pre>
</div>
<p>and:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl">Random movement
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">100001
</span></span><span class="line"><span class="cl">870003
</span></span><span class="line"><span class="cl">2401
</span></span><span class="line"><span class="cl">650002
</span></span><span class="line"><span class="cl">12000</span></span></code></pre>
</div>
<p>Both have previous insertion positions.</p>
<p>Only the first has previous positions that provide useful information about the next search.</p>
<p>So the problem became: <strong>how much locality is enough to justify a different search path?</strong></p>
<p>I tested different selector configurations across multiple hardware profiles.</p>
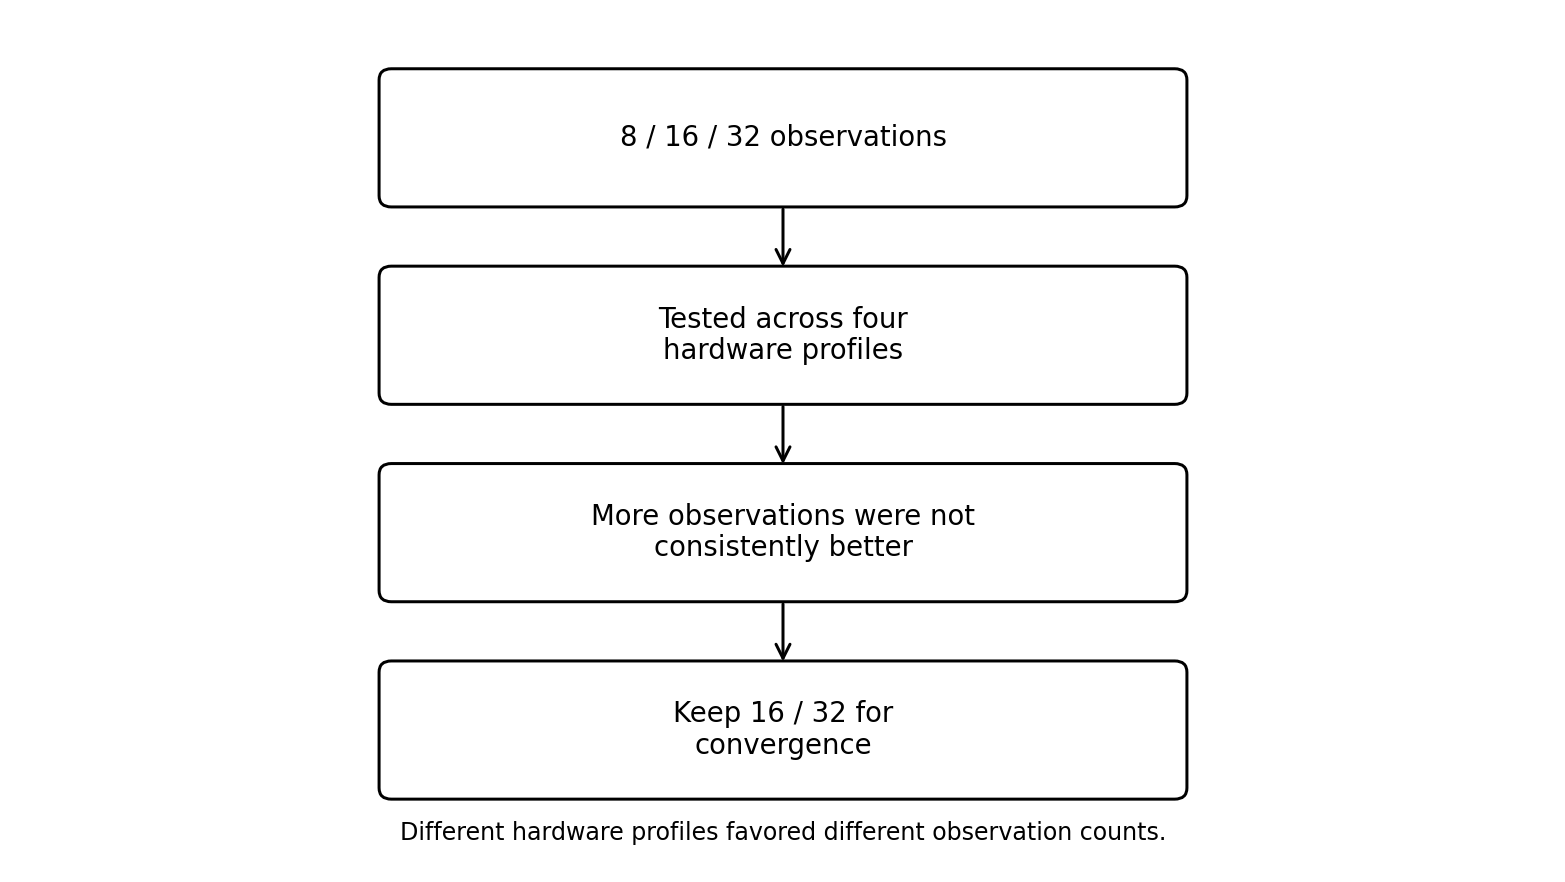
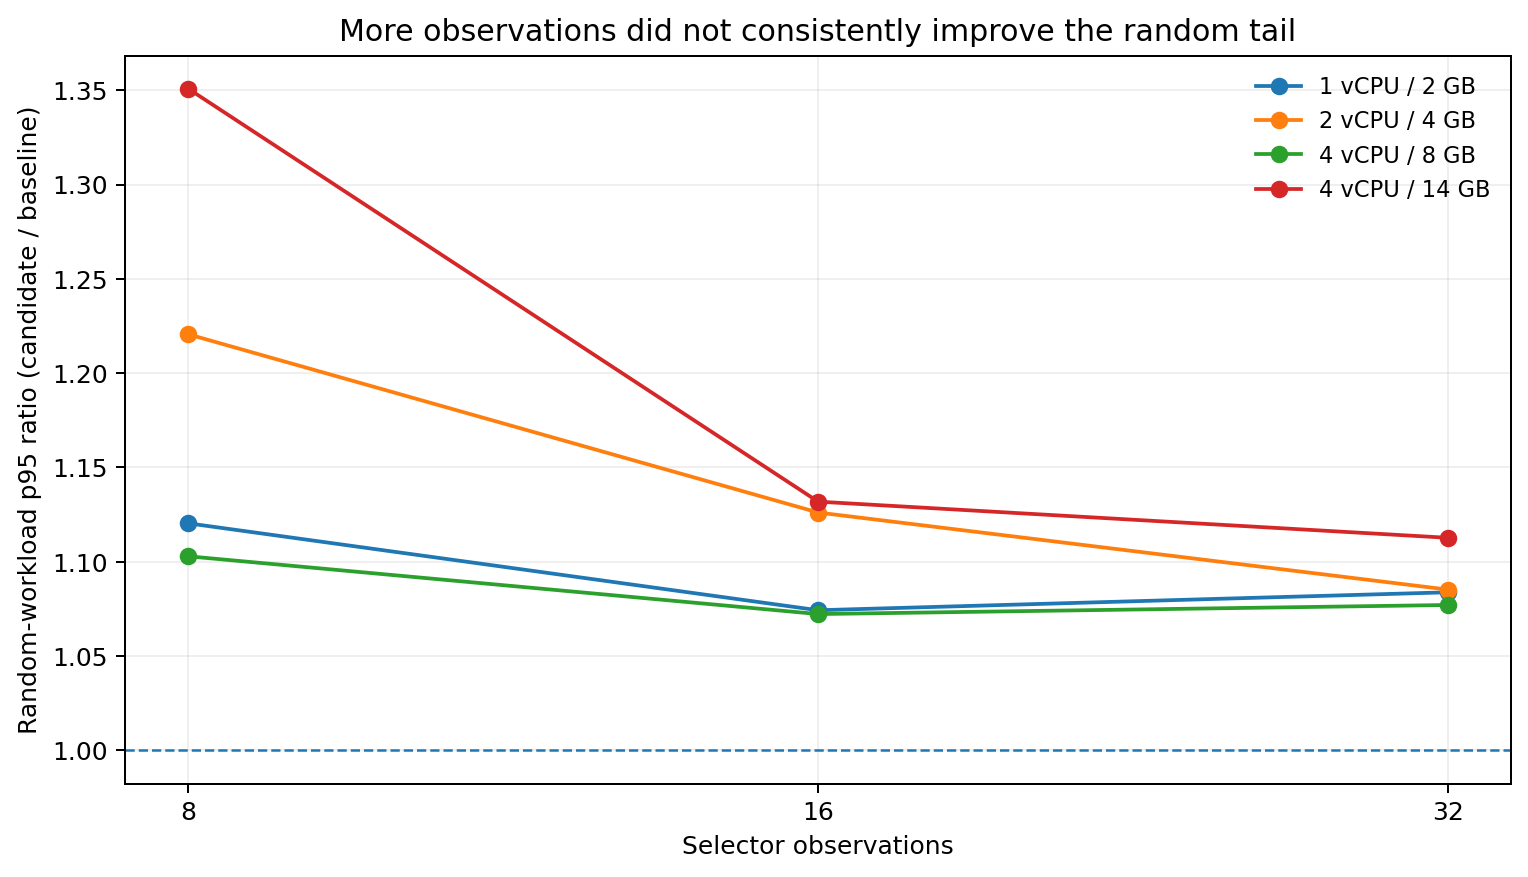
<p>One focused experiment compared <strong>8, 16, and 32 observations</strong> across four hardware profiles.</p>
<p>The important result was simple: more observations were not consistently better. Some systems favored 16, while others favored 32.</p>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/selector-convergence-flow.png" alt="Flow diagram showing the selector experiment progressing from 8, 16, and 32 observations to later convergence tests using only 16 and 32."></p>
<p><em>Figure 2. The observation-count experiment narrowed the later search space: 8 was dropped, while 16 and 32 were carried forward for convergence testing.</em></p>
<p>Those later experiments produced another useful result: once the basic selector was already rejecting random workloads reliably, adding more decision rules did not help. More complicated policies mainly rejected useful local cases.</p>
<p>At that point, the remaining problem was no longer classification.</p>
<p>It was overhead.</p>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/selector-observations.png" alt="Random-workload p95 candidate-to-baseline ratios for 8, 16, and 32 selector observations across four hardware profiles."></p>
<p><em>Figure 3. Focused selector experiment at level 4. Lower is better; the best observation count varies by hardware profile, so increasing from 16 to 32 was not uniformly beneficial.</em></p>
<h2 id="what-the-benchmarks-showed">What the benchmarks showed<a class="headerlink" href="#what-the-benchmarks-showed" title="Link to this heading">#</a></h2>
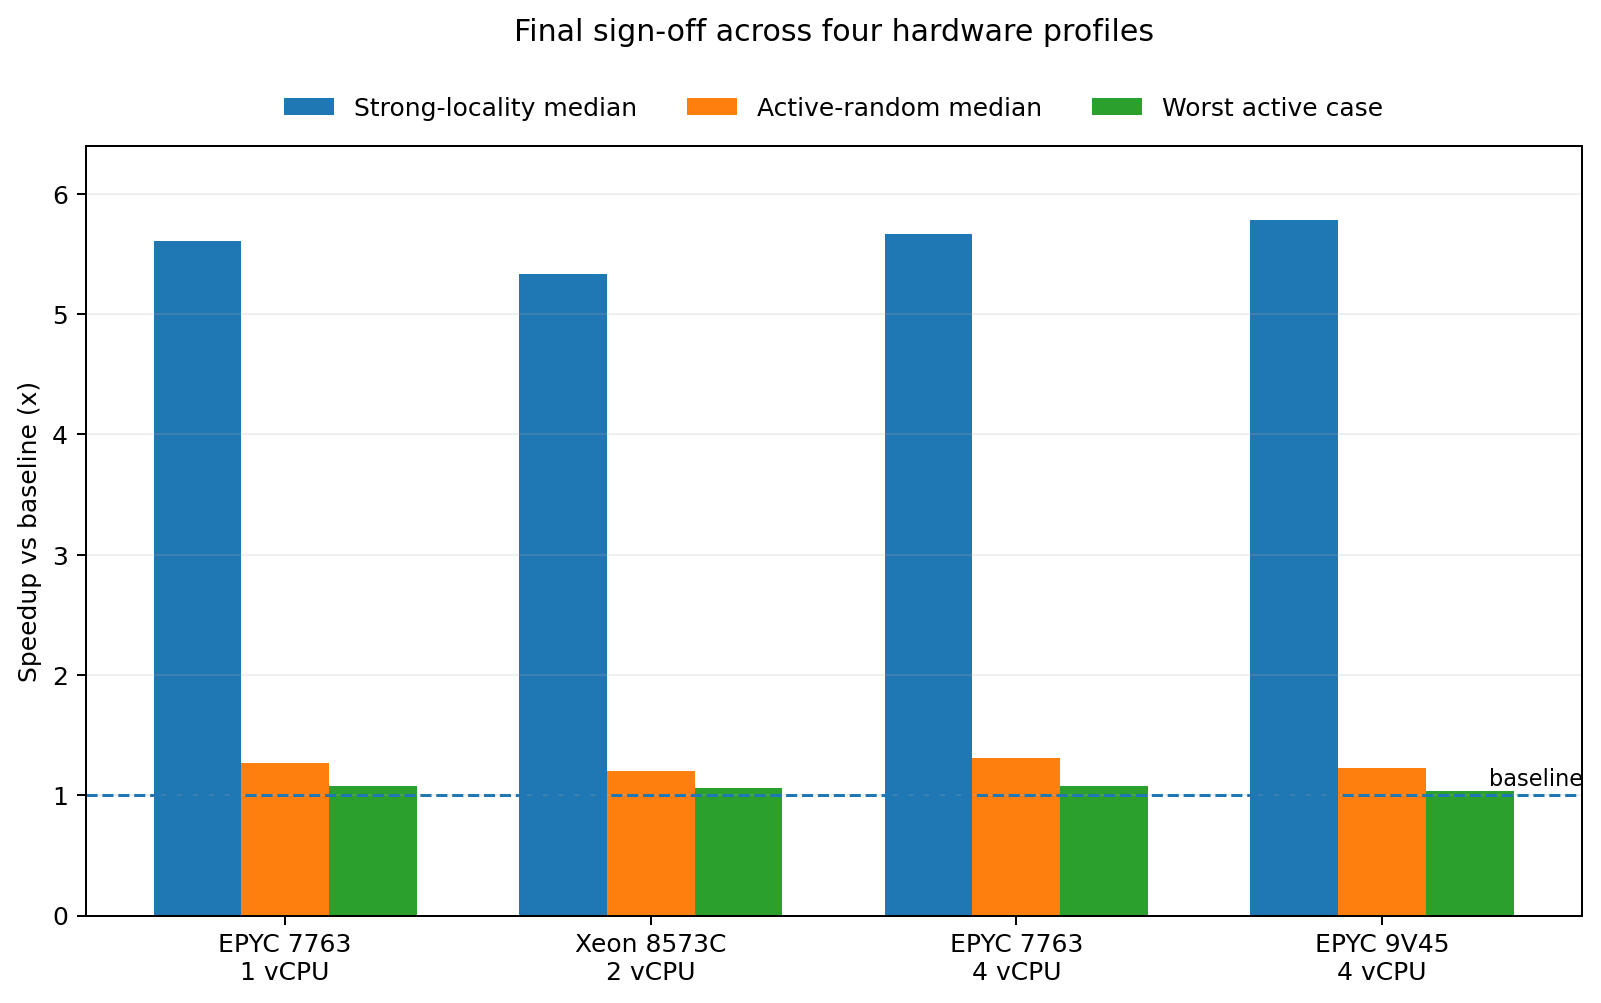
<p>The final sign-off covered four logical resource profiles and 72 workload cases per profile, for 288 case/profile combinations.</p>
<p>The matrix included:</p>
<ul>
<li><code>int32</code>, <code>int64</code>, and <code>float64</code></li>
<li><code>side=&quot;left&quot;</code> and <code>side=&quot;right&quot;</code></li>
<li>dense and duplicate-heavy arrays</li>
<li>strong-locality workloads</li>
<li>random workloads</li>
<li>reversal-heavy patterns</li>
<li>cases above and below the activation threshold</li>
</ul>
<p>Across the final profiles, strong-locality workloads showed median speedups of roughly <strong>5.3–5.8x</strong>.</p>
<table>
  <thead>
      <tr>
          <th>Runner</th>
          <th style="text-align: right">Strong-locality median</th>
          <th style="text-align: right">Active-random median</th>
          <th style="text-align: right">Worst active case</th>
      </tr>
  </thead>
  <tbody>
      <tr>
          <td>AMD EPYC 7763 / 1 vCPU</td>
          <td style="text-align: right">5.61x</td>
          <td style="text-align: right">1.27x</td>
          <td style="text-align: right">1.08x</td>
      </tr>
      <tr>
          <td>Intel Xeon Platinum 8573C / 2 vCPU</td>
          <td style="text-align: right">5.33x</td>
          <td style="text-align: right">1.20x</td>
          <td style="text-align: right">1.06x</td>
      </tr>
      <tr>
          <td>AMD EPYC 7763 / 4 vCPU</td>
          <td style="text-align: right">5.67x</td>
          <td style="text-align: right">1.31x</td>
          <td style="text-align: right">1.08x</td>
      </tr>
      <tr>
          <td>AMD EPYC 9V45 / 4 vCPU</td>
          <td style="text-align: right">5.78x</td>
          <td style="text-align: right">1.23x</td>
          <td style="text-align: right">1.04x</td>
      </tr>
  </tbody>
</table>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/final-signoff-benchmark.png" alt="Bar chart of final sign-off speedups across four hardware profiles, comparing strong-locality median, active-random median, and worst active case."></p>
<p><em>Figure 4. Final sign-off results. Strong-locality workloads gained more than 5x across all four profiles, while active random workloads and the worst active cases remained above baseline.</em></p>
<p>Earlier matrices showed the same pattern from another angle:</p>
<ul>
<li>dense workloads at roughly <code>0.16-0.19x</code> baseline runtime</li>
<li>duplicate-heavy workloads at roughly <code>0.13-0.15x</code></li>
<li>medium-locality workloads at roughly <code>0.38-0.47x</code></li>
</ul>
<p>The important result was not simply the largest speedup.</p>
<p>For a general-purpose numerical library, improving one workload while causing unpredictable regressions elsewhere is not a good trade.</p>
<p>The more useful result was that the local path could produce large gains while unrelated workloads remained on, or close to, the existing execution path.</p>
<h2 id="why-the-threshold-exists">Why the threshold exists<a class="headerlink" href="#why-the-threshold-exists" title="Link to this heading">#</a></h2>
<p>Initially, I expected locality alone to determine whether the optimization should run.</p>
<p>The benchmarks showed otherwise.</p>
<p>Even when locality exists, the workload has to be large enough to amortize the cost of observation, selection, branching, and path management.</p>
<p>At smaller query counts, it is possible to remove search work while still increasing wall-clock time.</p>
<p>This led to a separate activation gate.</p>
<p>For the final validation, I used</p>
<p>$Q \ge 2^{20}$</p>
<p>as a conservative activation gate.</p>
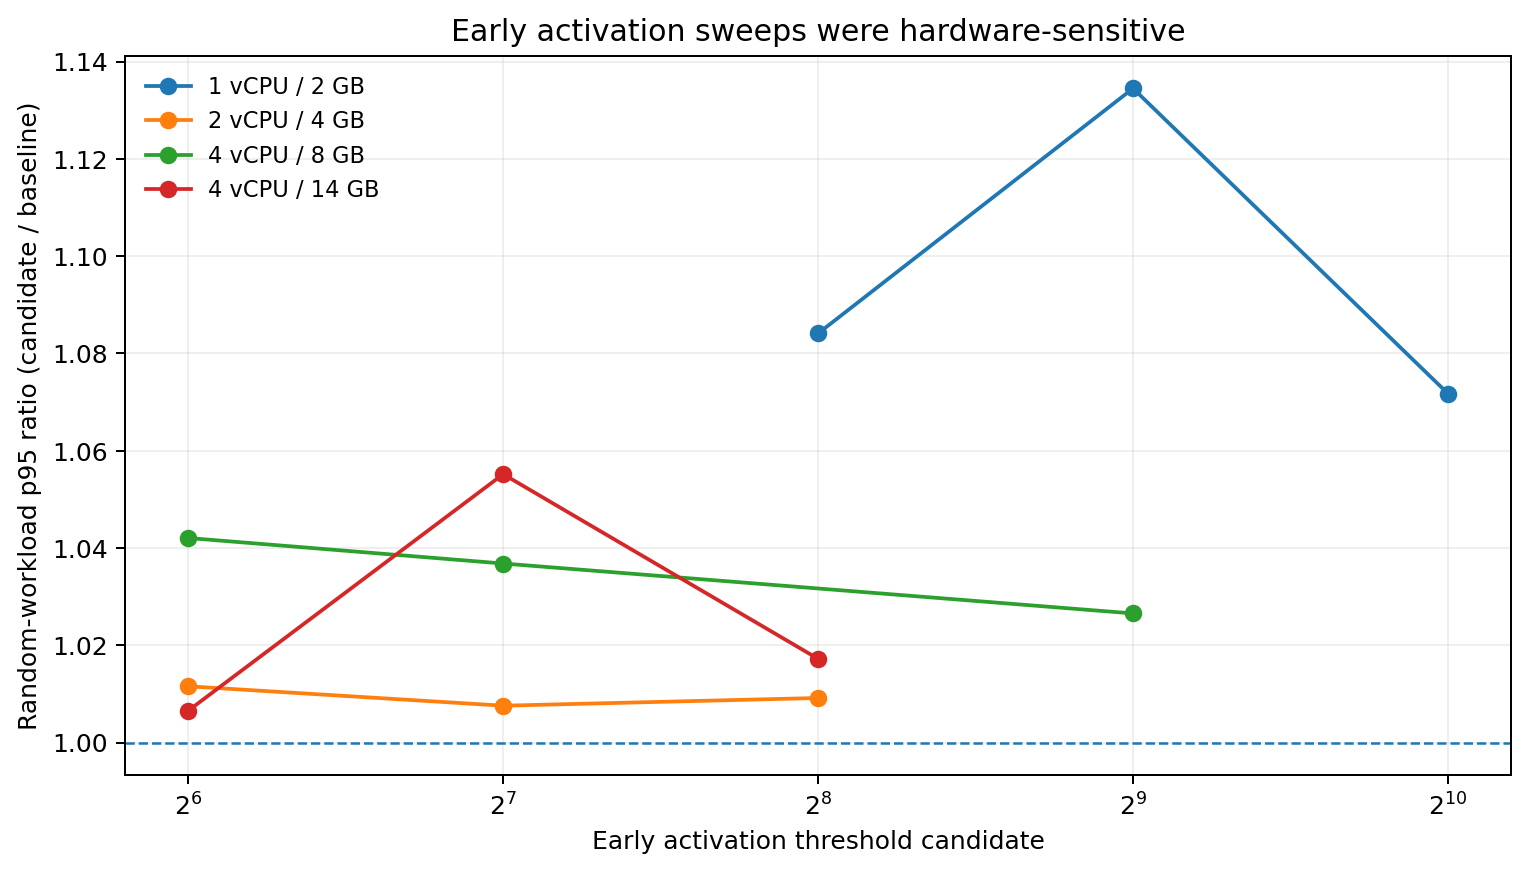
<p>There is nothing mathematically special about $2^{20}$. Earlier activation sweeps already showed why a portable gate needed to be conservative: three tested profiles could converge on a low activation candidate in that experimental setup, while the 1-vCPU / 2-GB profile failed the second-stage stability gate entirely.</p>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/early-activation-threshold-sweep.png" alt="Early activation-threshold sweep showing different random-workload p95 behavior across four hardware profiles."></p>
<p><em>Figure 5. Early activation sweeps were hardware-sensitive. Three profiles converged on low candidates in this experiment, while the 1-vCPU / 2-GB profile failed the second-stage stability gate. This exploratory sweep motivated a more conservative portable policy; it does not directly define the final $2^{20}$ gate.</em></p>
<p>The exact crossover therefore depends on the machine and on the surrounding selector design. The final validation gate was intentionally more conservative than those early exploratory thresholds.</p>
<p>A useful reminder from this experiment: <strong>a cheaper algorithmic path is not automatically a faster CPU path.</strong></p>
<h2 id="then-i-found-the-earlier-numpy-optimization">Then I found the earlier NumPy optimization<a class="headerlink" href="#then-i-found-the-earlier-numpy-optimization" title="Link to this heading">#</a></h2>
<p>Only after implementing and validating this work did I come across <a href="https://github.com/numpy/numpy/pull/30517">NumPy PR #30517</a> and the Scientific Python article <a href="https://blog.scientific-python.org/numpy/searchsorted/">Making <code>np.searchsorted</code> up to 25x Faster in NumPy 2.5</a>.</p>
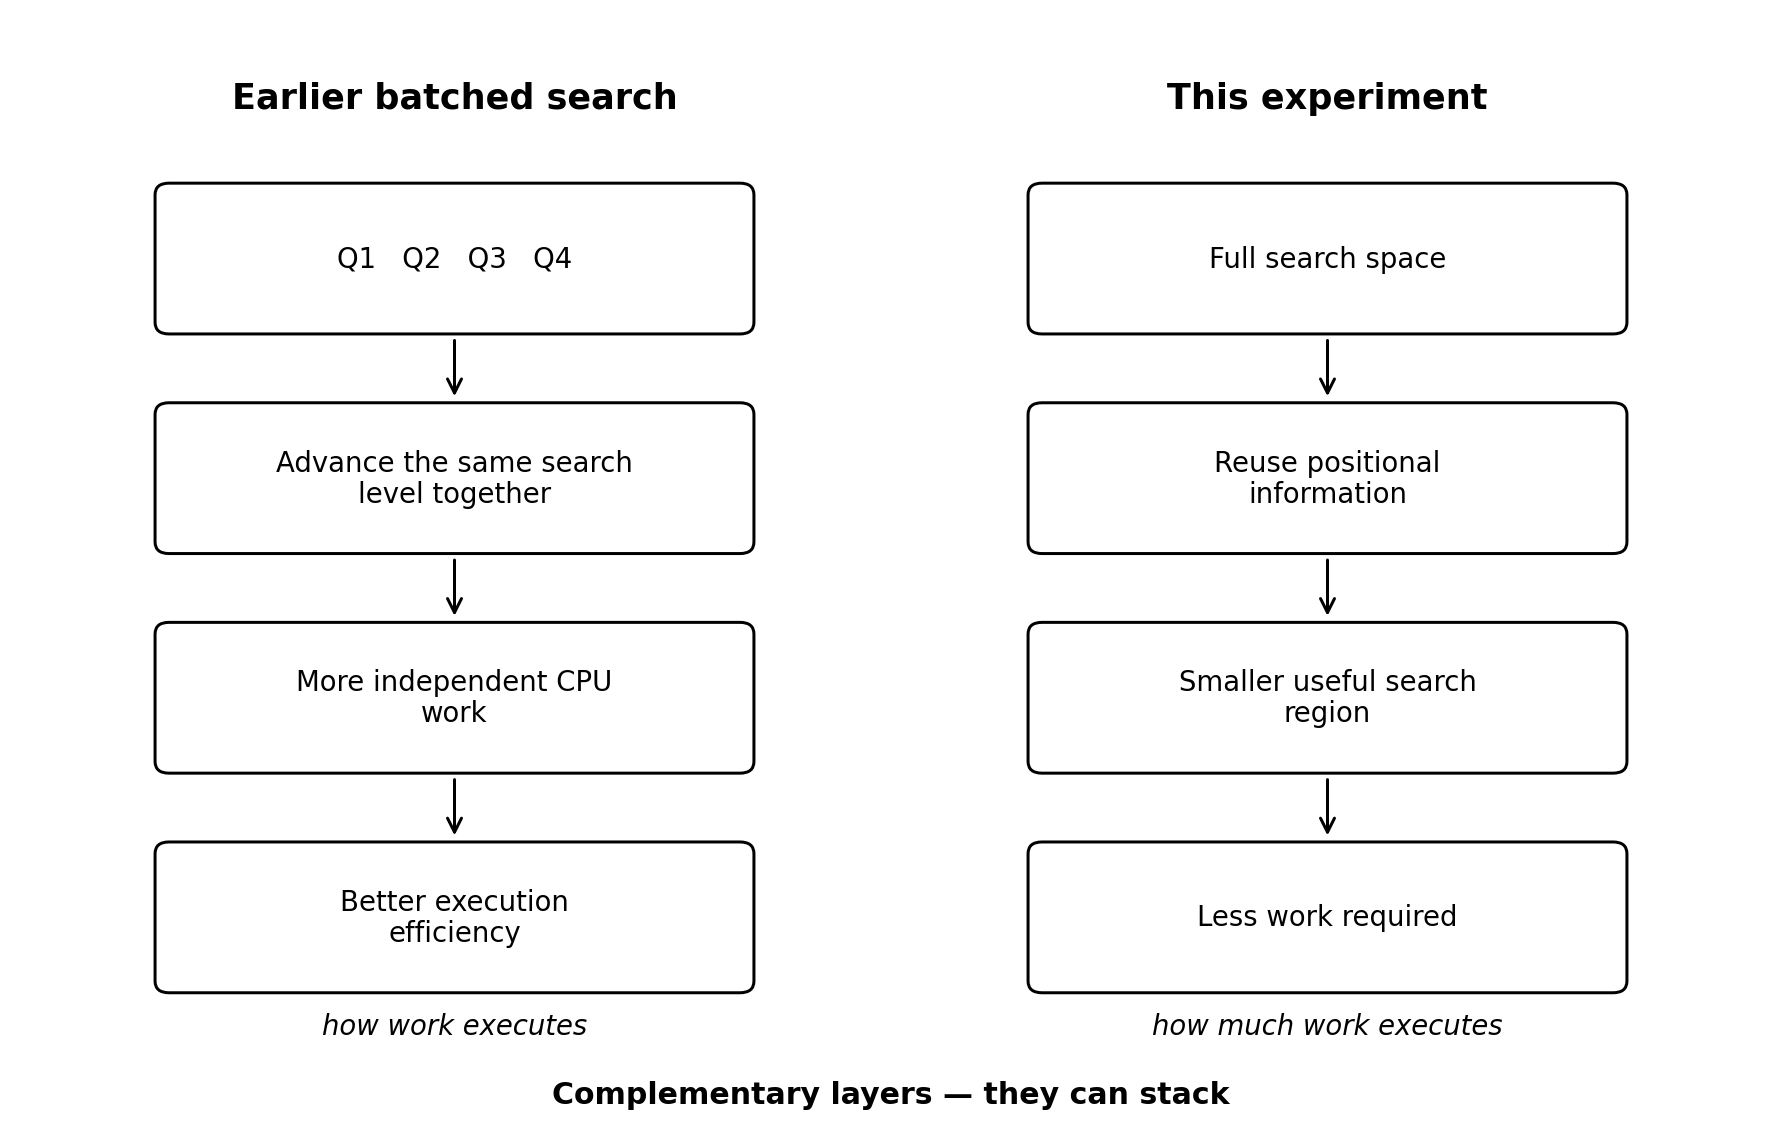
<p>What was interesting was that the earlier work and this experiment were optimizing different layers of the same problem.</p>
<p><img src="/numpy/finding-another-layer-of-performance-in-np-searchsorted/two-layers-of-optimization.png" alt="Diagram comparing earlier batched-search work, which improves how searches execute, with this experiment, which reduces how much search work is required."></p>
<p><em>Figure 6. The earlier batched-search work improves execution efficiency; this experiment reduces the amount of work. The two approaches are complementary and can stack.</em></p>
<p>The earlier work improves <strong>how the searches execute</strong>. This experiment focuses on <strong>how much searching is necessary</strong>.</p>
<h2 id="a-second-layer-of-optimization">A second layer of optimization<a class="headerlink" href="#a-second-layer-of-optimization" title="Link to this heading">#</a></h2>
<p>This was the part of the experiment I found most useful beyond <code>searchsorted</code>.</p>
<p>Performance work often begins with: <strong>How can this computation execute faster?</strong></p>
<p>But there is another question worth asking: <strong>Does all of this computation still need to happen?</strong></p>
<p>Modern CPUs can gain substantially from batching, overlapping independent work, and improving memory behavior.</p>
<p>But after making execution more efficient, another opportunity may remain: use information the program has already produced to remove work entirely.</p>
<p>In this case, insertion positions were not just outputs.</p>
<p>They were structure.</p>
<p>And reusing that structure exposed another layer of performance.</p>
<p>A NumPy implementation of this experiment is currently under review in <a href="https://github.com/numpy/numpy/pull/32895">PR #32895</a>. The results discussed here describe the performance experiment itself rather than the outcome of that review.</p>
<p>The code and related experiments are available through <a href="https://github.com/Johnny-Kao">my GitHub profile</a>.</p>
]]></content>


                                <category scheme="taxonomy:Tags" term="numpy" label="numpy" />
                             
                                <category scheme="taxonomy:Tags" term="performance" label="performance" />


        </entry>
    
        
        <entry>
            <title type="html"><![CDATA[Making np.searchsorted up to 25× Faster in NumPy 2.5]]></title>
            <link href="https://blog.scientific-python.org/numpy/searchsorted/?utm_source=atom_feed" rel="alternate" type="text/html" />
            
                <link href="https://blog.scientific-python.org/numpy/fellowship-program-2025-retrospective/?utm_source=atom_feed" rel="related" type="text/html" title="A Year of Typing: My NumPy Fellowship Retrospective" />
                <link href="https://blog.scientific-python.org/numpy/fellowship-program-2025/?utm_source=atom_feed" rel="related" type="text/html" title="NumPy&#39;s Second Developer in Residence: Joren Hammudoglu" />
                <link href="https://blog.scientific-python.org/numpy/numpy2/?utm_source=atom_feed" rel="related" type="text/html" title="NumPy 2.0: an evolutionary milestone" />
                <link href="https://blog.scientific-python.org/numpy/numpy-rng/?utm_source=atom_feed" rel="related" type="text/html" title="Best Practices for Using NumPy&#39;s Random Number Generators" />
                <link href="https://blog.scientific-python.org/numpy/fellowship-program/?utm_source=atom_feed" rel="related" type="text/html" title="NumPy&#39;s first Developer in Residence: Sayed Adel" />
            
                <id>https://blog.scientific-python.org/numpy/searchsorted/</id>
            
            
            <published>2026-09-29T00:00:00+00:00</published>
            <updated>2026-09-29T00:00:00+00:00</updated>
            
            
            <content type="html"><![CDATA[<blockquote>How vectorizing independent binary searches and reducing per-query state can make np.searchsorted up to 25× faster.</blockquote><p><code>np.searchsorted</code> is NumPy&rsquo;s implementation of the binary search algorithm. This is one of the fundamental search algorithms and is used in the Python scientific ecosystem for functionality such as histogram computation and interval lookups. Any optimization benefits libraries such as SciPy and scikit-learn, as well as the broader Python scientific ecosystem.</p>
<p>Several case studies, such as <a href="https://curiouscoding.nl/posts/binsearch/">Binary search variants and the effects of batching</a> and <a href="https://en.algorithmica.org/hpc/data-structures/binary-search/">Algorithmica&rsquo;s Binary Search case study</a> explore techniques such as branch elimination, batching, and cache-friendly data layouts to binary search performance. In this post, we explore how those ideas can be expressed using NumPy&rsquo;s vectorized primitives.</p>
<p>We will derive a vectorized formulation that outperforms NumPy 2.4&rsquo;s searchsorted implementation, and then port the resulting algorithm back into NumPy. The change was included in NumPy 2.5, achieving up to a 25× speedup in our benchmarks.</p>
<p><code>searchsorted</code> is also part of the <a href="https://data-apis.org/array-api/latest/API_specification/generated/array_api.searchsorted.html#array_api.searchsorted">Python Array API Standard</a>. This allows us to compare how different array libraries implement the same operation and exploit parallelism.</p>
<h2 id="problem-definition">Problem definition<a class="headerlink" href="#problem-definition" title="Link to this heading">#</a></h2>
<p>Given a static sorted array and a sequence of query keys, find the insertion position of each key in the array.</p>
<p>A classic pure-Python implementation runs one binary search per key:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">def</span> <span class="nf">searchsorted_py</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">xs</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">    <span class="n">res</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">empty</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">xs</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">int32</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="n">xs</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">        <span class="n">lo</span> <span class="o">=</span> <span class="mi">0</span>
</span></span><span class="line"><span class="cl">        <span class="n">hi</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">a</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="k">while</span> <span class="n">lo</span> <span class="o">&lt;</span> <span class="n">hi</span><span class="p">:</span>
</span></span><span class="line"><span class="cl">            <span class="n">mid</span> <span class="o">=</span> <span class="p">(</span><span class="n">lo</span> <span class="o">+</span> <span class="n">hi</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
</span></span><span class="line"><span class="cl">            <span class="k">if</span> <span class="n">a</span><span class="p">[</span><span class="n">mid</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">x</span><span class="p">:</span>
</span></span><span class="line"><span class="cl">                <span class="n">lo</span> <span class="o">=</span> <span class="n">mid</span> <span class="o">+</span> <span class="mi">1</span>
</span></span><span class="line"><span class="cl">            <span class="k">else</span><span class="p">:</span>
</span></span><span class="line"><span class="cl">                <span class="n">hi</span> <span class="o">=</span> <span class="n">mid</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="n">res</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="n">lo</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">return</span> <span class="n">res</span></span></span></code></pre>
</div>
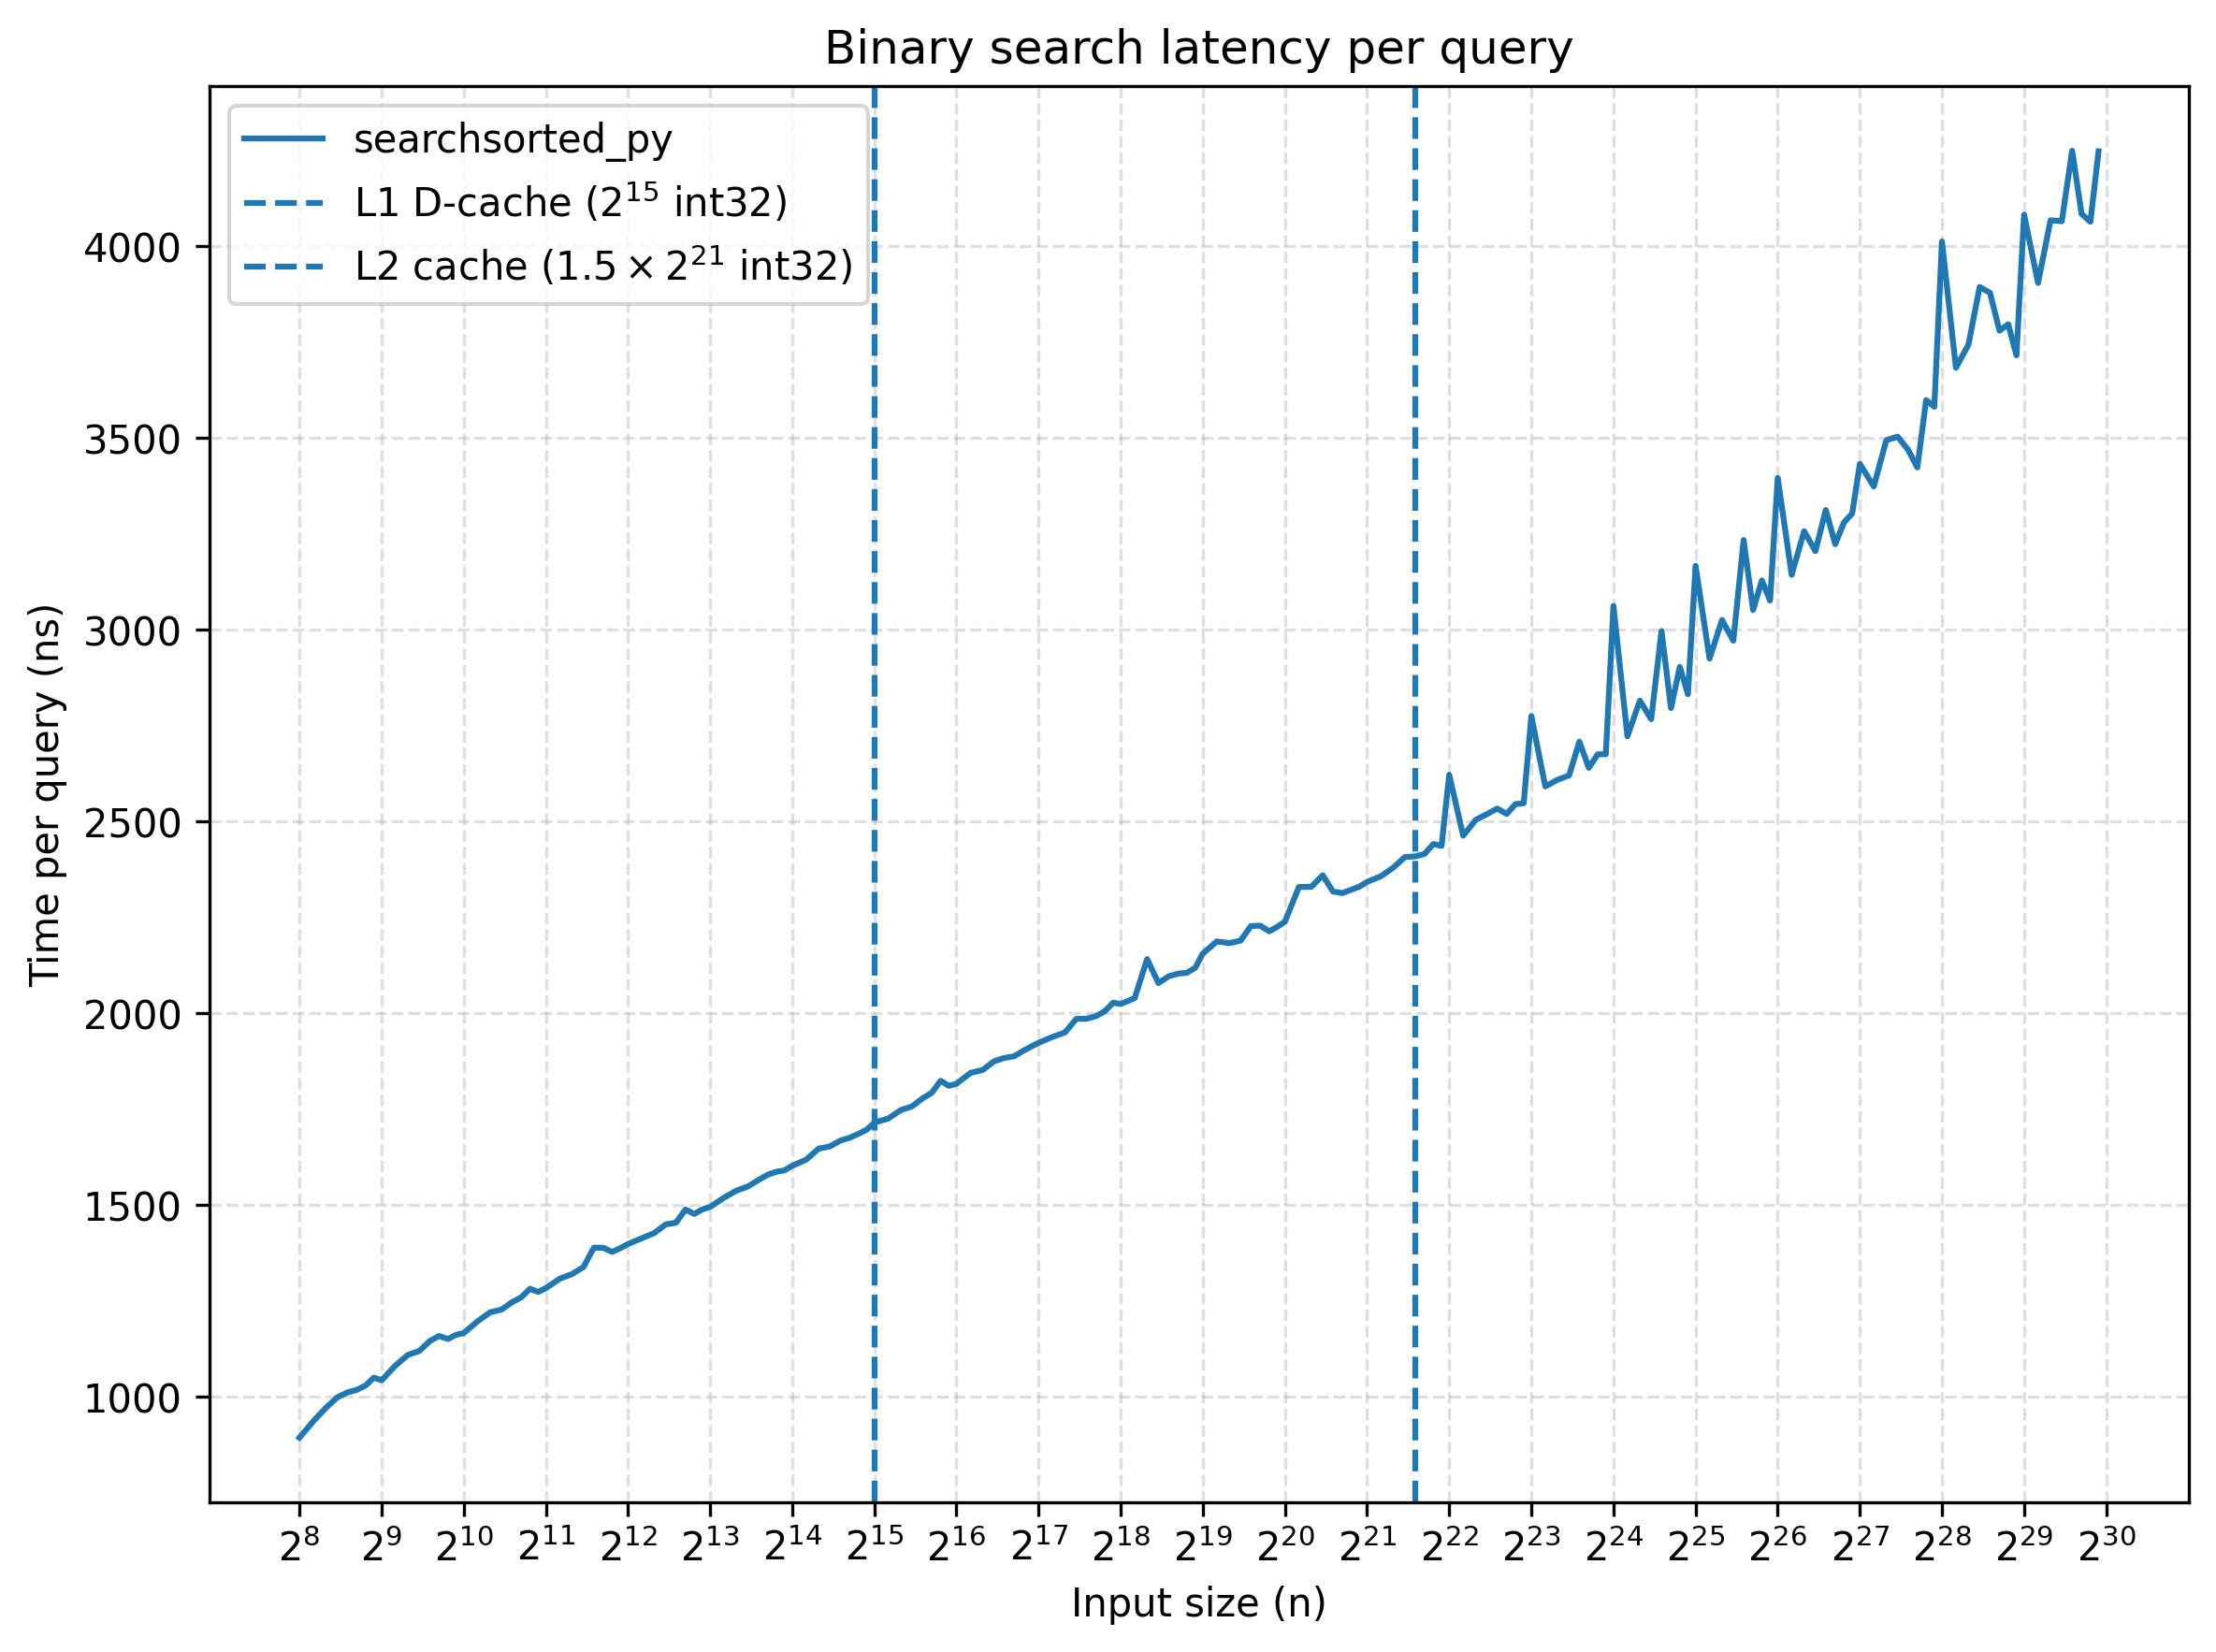
<p><img src="/numpy/searchsorted/images/figure1-fs8.png" alt=""></p>
<p>Running time per query grows logarithmically as the input size grows (note the logarithmic scale of x-axis).</p>
<p>For benchmarking, we generated two random arrays of uniformly distributed <code>np.int32</code> integers. The keys (i.e. the elements being searched) had a fixed length of 10,000, while the length of the sorted array varied up to $2^{30}$ ($4\ GiB$). Both keys and values arrays are contiguous in memory. Each benchmark was repeated 50 times, and we report the minimum execution time.</p>
<p>The benchmarks were run on a MacBook Pro with an Apple M1 Pro and 32 GB of memory. The M1 Pro has 128 KB of L1 data cache per performance core, enough to hold $2^{15}$ 32-bit integers, and a 12 MB L2 cache shared by its performance cores, enough to hold $1.5 * 2^{21}$ 32-bit integers.</p>
<h2 id="batching-with-numpy-arrays">Batching with NumPy arrays<a class="headerlink" href="#batching-with-numpy-arrays" title="Link to this heading">#</a></h2>
<p>The baseline implementation performs one binary search per query. Each search is independent, but executed sequentially in Python. We can adapt the algorithm so multiple binary searches make progress together in batches. For that we can represent the state of all searches as arrays and update them simultaneously using vectorized operations.</p>
<p>In NumPy, operations on arrays are executed in compiled C++ loops. This removes Python overhead and allows the CPU to efficiently process large batches of independent work.</p>
<h2 id="lets-vectorize-our-binary-search">Let&rsquo;s vectorize our binary search<a class="headerlink" href="#lets-vectorize-our-binary-search" title="Link to this heading">#</a></h2>
<p>To vectorize the algorithm, we reinterpret scalar variables as array state. Instead of a single <code>lo</code> and <code>hi</code>, we maintain one value per query. In our original implementation, the state consists of <code>lo</code>, <code>hi</code>, and <code>res</code>. Since <code>lo</code> ends up containing the final result, we can focus on tracking just <code>lo</code> and <code>hi</code>.</p>
<p>This first vectorized implementation is a direct translation of the previous algorithm.</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">def</span> <span class="nf">searchsorted_py_np</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">xs</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">    <span class="n">lo</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">xs</span><span class="o">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">int32</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">    <span class="n">hi</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">full</span><span class="p">(</span><span class="n">xs</span><span class="o">.</span><span class="n">shape</span><span class="p">,</span> <span class="nb">len</span><span class="p">(</span><span class="n">a</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">int32</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">while</span> <span class="kc">True</span><span class="p">:</span>
</span></span><span class="line"><span class="cl">        <span class="c1"># True for each element position where lo_i &lt; hi_i</span>
</span></span><span class="line"><span class="cl">        <span class="n">active</span> <span class="o">=</span> <span class="n">lo</span> <span class="o">&lt;</span> <span class="n">hi</span>
</span></span><span class="line"><span class="cl">        <span class="k">if</span> <span class="ow">not</span> <span class="n">np</span><span class="o">.</span><span class="n">any</span><span class="p">(</span><span class="n">active</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">            <span class="c1"># this is basically `while lo &lt; hi:` in the pure-Python version</span>
</span></span><span class="line"><span class="cl">            <span class="k">break</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="n">mid</span> <span class="o">=</span> <span class="p">(</span><span class="n">lo</span> <span class="o">+</span> <span class="n">hi</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="c1"># only index those entries where active is true, so we don&#39;t modify already computed positions</span>
</span></span><span class="line"><span class="cl">        <span class="n">mid_a</span> <span class="o">=</span> <span class="n">mid</span><span class="p">[</span><span class="n">active</span><span class="p">]</span>
</span></span><span class="line"><span class="cl">        <span class="n">xs_a</span> <span class="o">=</span> <span class="n">xs</span><span class="p">[</span><span class="n">active</span><span class="p">]</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="n">mask</span> <span class="o">=</span> <span class="n">a</span><span class="p">[</span><span class="n">mid_a</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">xs_a</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="n">lo</span><span class="p">[</span><span class="n">active</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">mask</span><span class="p">,</span> <span class="n">mid_a</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">lo</span><span class="p">[</span><span class="n">active</span><span class="p">])</span>
</span></span><span class="line"><span class="cl">        <span class="n">hi</span><span class="p">[</span><span class="n">active</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">mask</span><span class="p">,</span> <span class="n">hi</span><span class="p">[</span><span class="n">active</span><span class="p">],</span> <span class="n">mid_a</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">return</span> <span class="n">lo</span></span></span></code></pre>
</div>
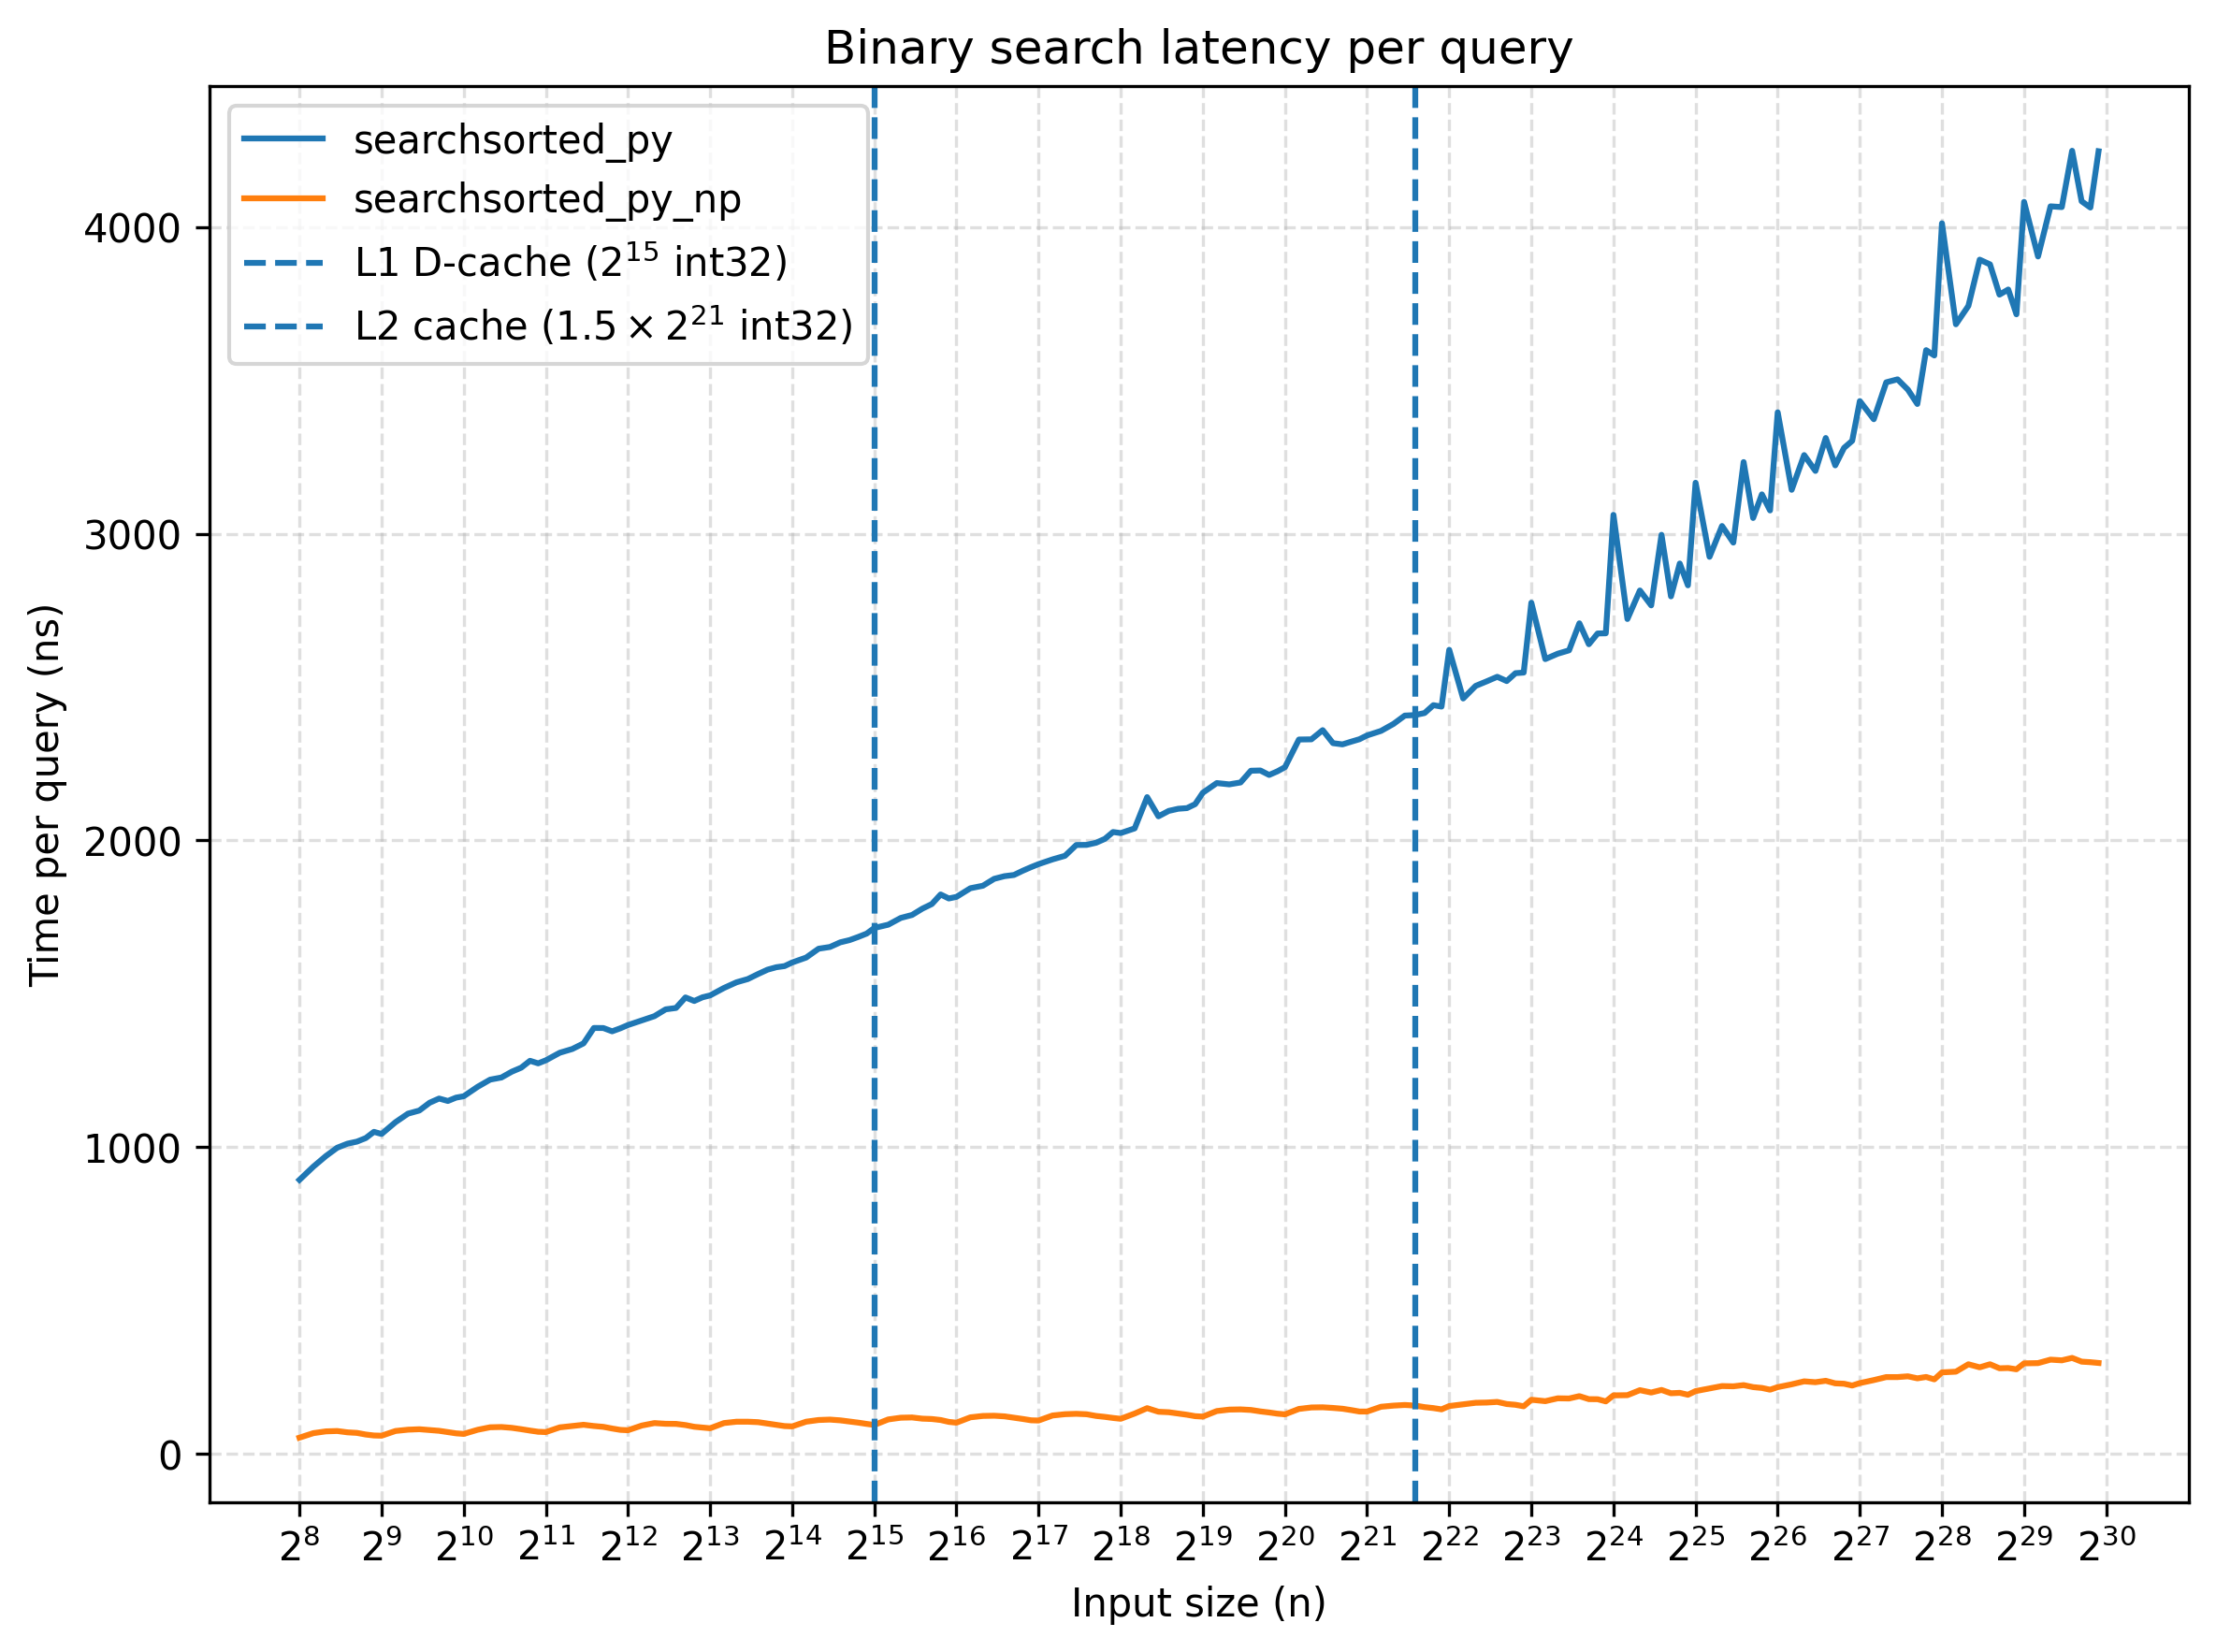
<p><img src="/numpy/searchsorted/images/figure2-fs8.png" alt=""></p>
<p>In this implementation, different queries can shrink their search intervals at different rates, so they may require different numbers of iterations to converge.</p>
<p>For example, consider searching for the keys <code>[-1, 2]</code> in the array <code>[0, 1]</code>. For the query <code>2</code>, the first iteration computes <code>mid = 1</code> and sets <code>lo = mid + 1 = 2</code>, so the interval becomes <code>[2, 2)</code> and the search converges in one step. For the query <code>-1</code>, the update instead sets <code>hi = mid = 1</code>, leaving the interval <code>[0, 1)</code> after the first step. This requires an additional iteration to collapse the interval to <code>[0, 0)</code>.</p>
<p>Because the searches can converge at different times, we need to keep track of which queries are still active. The active mask identifies the queries whose search intervals have not yet converged, allowing us to update only those queries.</p>
<h3 id="making-all-searches-take-the-same-number-of-steps">Making all searches take the same number of steps<a class="headerlink" href="#making-all-searches-take-the-same-number-of-steps" title="Link to this heading">#</a></h3>
<p>The important observation is that binary search does not actually need to terminate independently for each key. We can tweak each iteration update in a way that, once a search has converged, subsequent iterations can leave its interval unchanged.</p>
<p>We maintain the invariant that the insertion position lies in <code>[lo, hi)</code>. At each iteration, every interval is reduced to roughly half its previous size. After <code>np.ceil(np.log2(n))</code> iterations, every interval has collapsed to a single position.</p>
<p>For simplicity, this implementation assumes <code>a</code> is non-empty.</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">def</span> <span class="nf">searchsorted_py_np_fixed</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">xs</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">    <span class="n">n</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">a</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">    <span class="n">lo</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">xs</span><span class="o">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">int32</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">    <span class="n">hi</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">full</span><span class="p">(</span><span class="n">xs</span><span class="o">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">int32</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="nb">int</span><span class="p">(</span><span class="n">np</span><span class="o">.</span><span class="n">ceil</span><span class="p">(</span><span class="n">np</span><span class="o">.</span><span class="n">log2</span><span class="p">(</span><span class="n">n</span><span class="p">)))):</span>
</span></span><span class="line"><span class="cl">        <span class="n">mid</span> <span class="o">=</span> <span class="p">(</span><span class="n">lo</span> <span class="o">+</span> <span class="n">hi</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
</span></span><span class="line"><span class="cl">        <span class="n">go_left</span> <span class="o">=</span> <span class="n">xs</span> <span class="o">&lt;=</span> <span class="n">a</span><span class="p">[</span><span class="n">mid</span><span class="p">]</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="c1"># for each position i:</span>
</span></span><span class="line"><span class="cl">        <span class="c1"># if go_left_i is True, we keep the `lo_i` value and `hi_i` is updated to `mid_i`</span>
</span></span><span class="line"><span class="cl">        <span class="c1"># if go_left_i is False, we keep the `hi_i` value and `lo_i` is updated to `mid_i`</span>
</span></span><span class="line"><span class="cl">        <span class="n">lo</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">go_left</span><span class="p">,</span> <span class="n">lo</span><span class="p">,</span> <span class="n">mid</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">        <span class="n">hi</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">go_left</span><span class="p">,</span> <span class="n">mid</span><span class="p">,</span> <span class="n">hi</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">return</span> <span class="n">hi</span></span></span></code></pre>
</div>
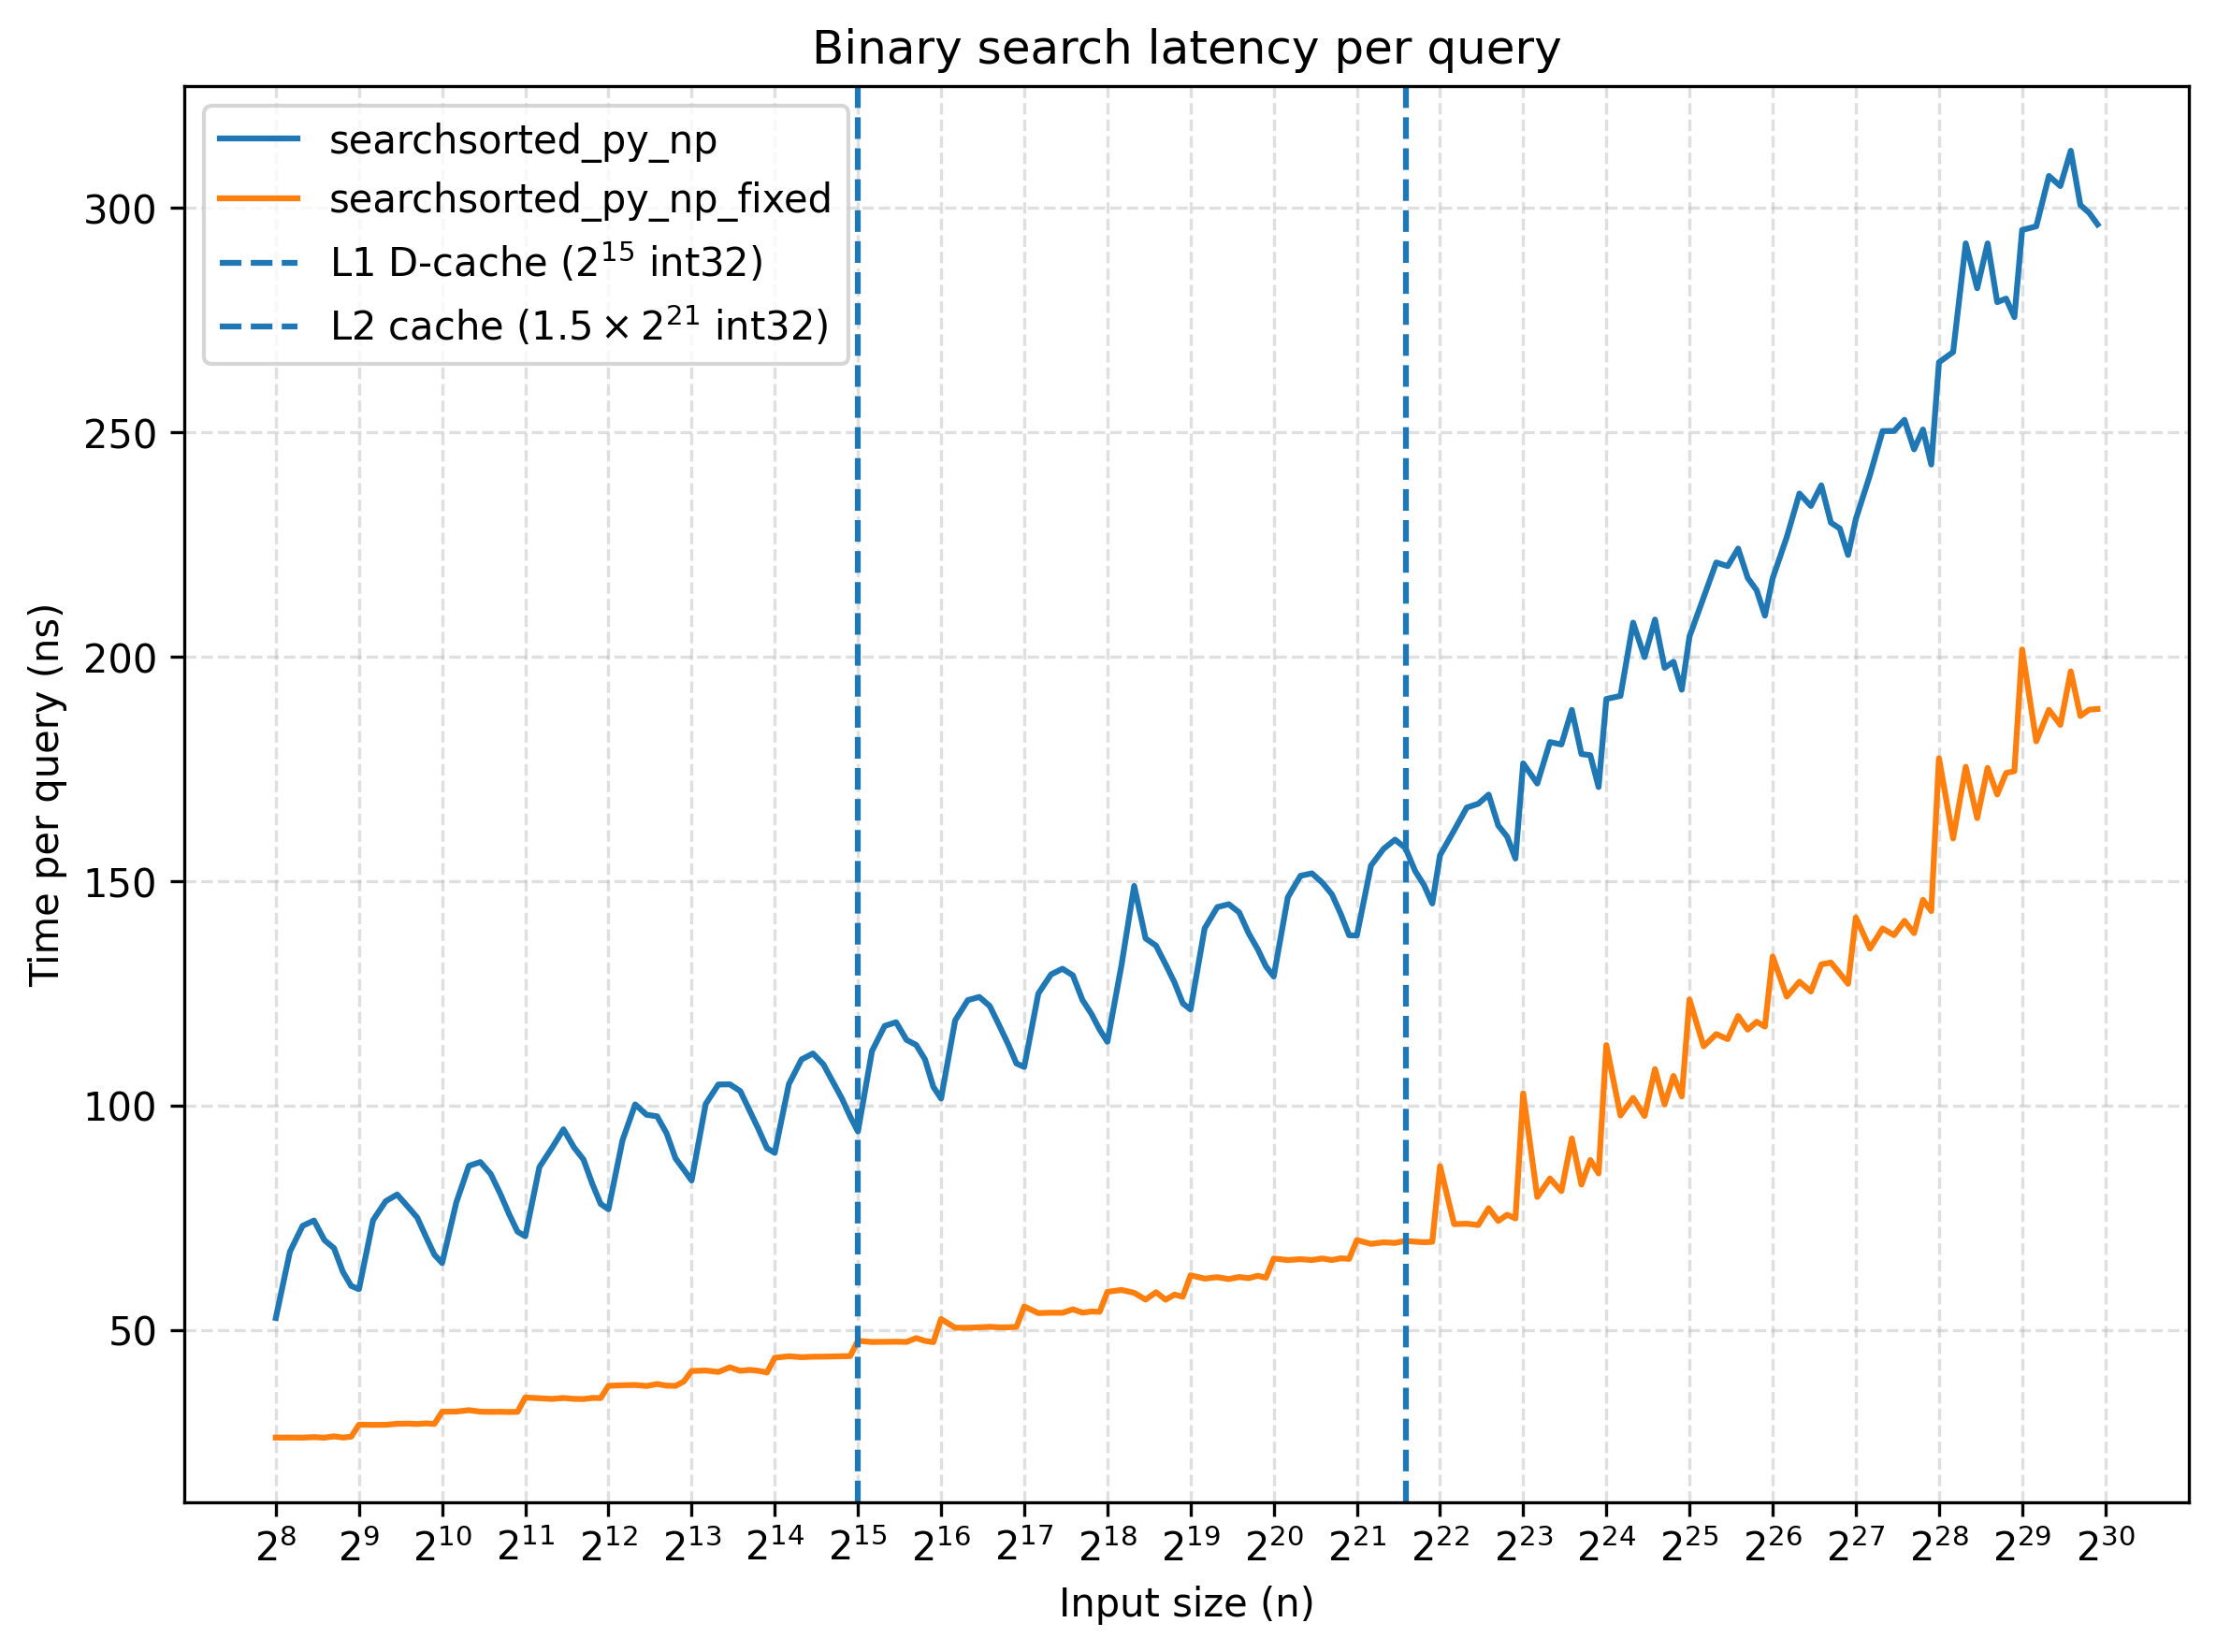
<p>Removing the <code>active</code> tracker makes it up to 2× faster.</p>
<p><img src="/numpy/searchsorted/images/figure3-fs8.png" alt=""></p>
<p>A similar formulation can already be found in the Python ecosystem. For example, <a href="https://github.com/jax-ml/jax/blob/a6e4a8b95a731269bdf23e5b3e30da2f8494bb28/jax/_src/numpy/hijax.py#L330">JAX’s scan-based implementation</a></p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="o">...</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl"><span class="k">def</span> <span class="nf">body_fun</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">_</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">    <span class="n">low</span><span class="p">,</span> <span class="n">high</span> <span class="o">=</span> <span class="n">state</span>
</span></span><span class="line"><span class="cl">    <span class="n">mid</span> <span class="o">=</span> <span class="n">low</span> <span class="o">+</span> <span class="p">(</span><span class="n">high</span> <span class="o">-</span> <span class="n">low</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>  <span class="c1"># use this form to avoid overflow</span>
</span></span><span class="line"><span class="cl">    <span class="n">go_left</span> <span class="o">=</span> <span class="n">op</span><span class="p">(</span><span class="n">query</span><span class="p">,</span> <span class="n">sorted_arr</span><span class="p">[</span><span class="n">mid</span><span class="p">])</span>
</span></span><span class="line"><span class="cl">    <span class="k">return</span> <span class="p">(</span><span class="n">lax</span><span class="o">.</span><span class="n">select</span><span class="p">(</span><span class="n">go_left</span><span class="p">,</span> <span class="n">low</span><span class="p">,</span> <span class="n">mid</span><span class="p">),</span> <span class="n">lax</span><span class="o">.</span><span class="n">select</span><span class="p">(</span><span class="n">go_left</span><span class="p">,</span> <span class="n">mid</span><span class="p">,</span> <span class="n">high</span><span class="p">)),</span> <span class="p">()</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl"><span class="n">n_levels</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">np</span><span class="o">.</span><span class="n">ceil</span><span class="p">(</span><span class="n">np</span><span class="o">.</span><span class="n">log2</span><span class="p">(</span><span class="n">n</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)))</span>
</span></span><span class="line"><span class="cl"><span class="o">...</span></span></span></code></pre>
</div>
<h3 id="can-numpy-beat-numpy">Can NumPy beat NumPy?<a class="headerlink" href="#can-numpy-beat-numpy" title="Link to this heading">#</a></h3>
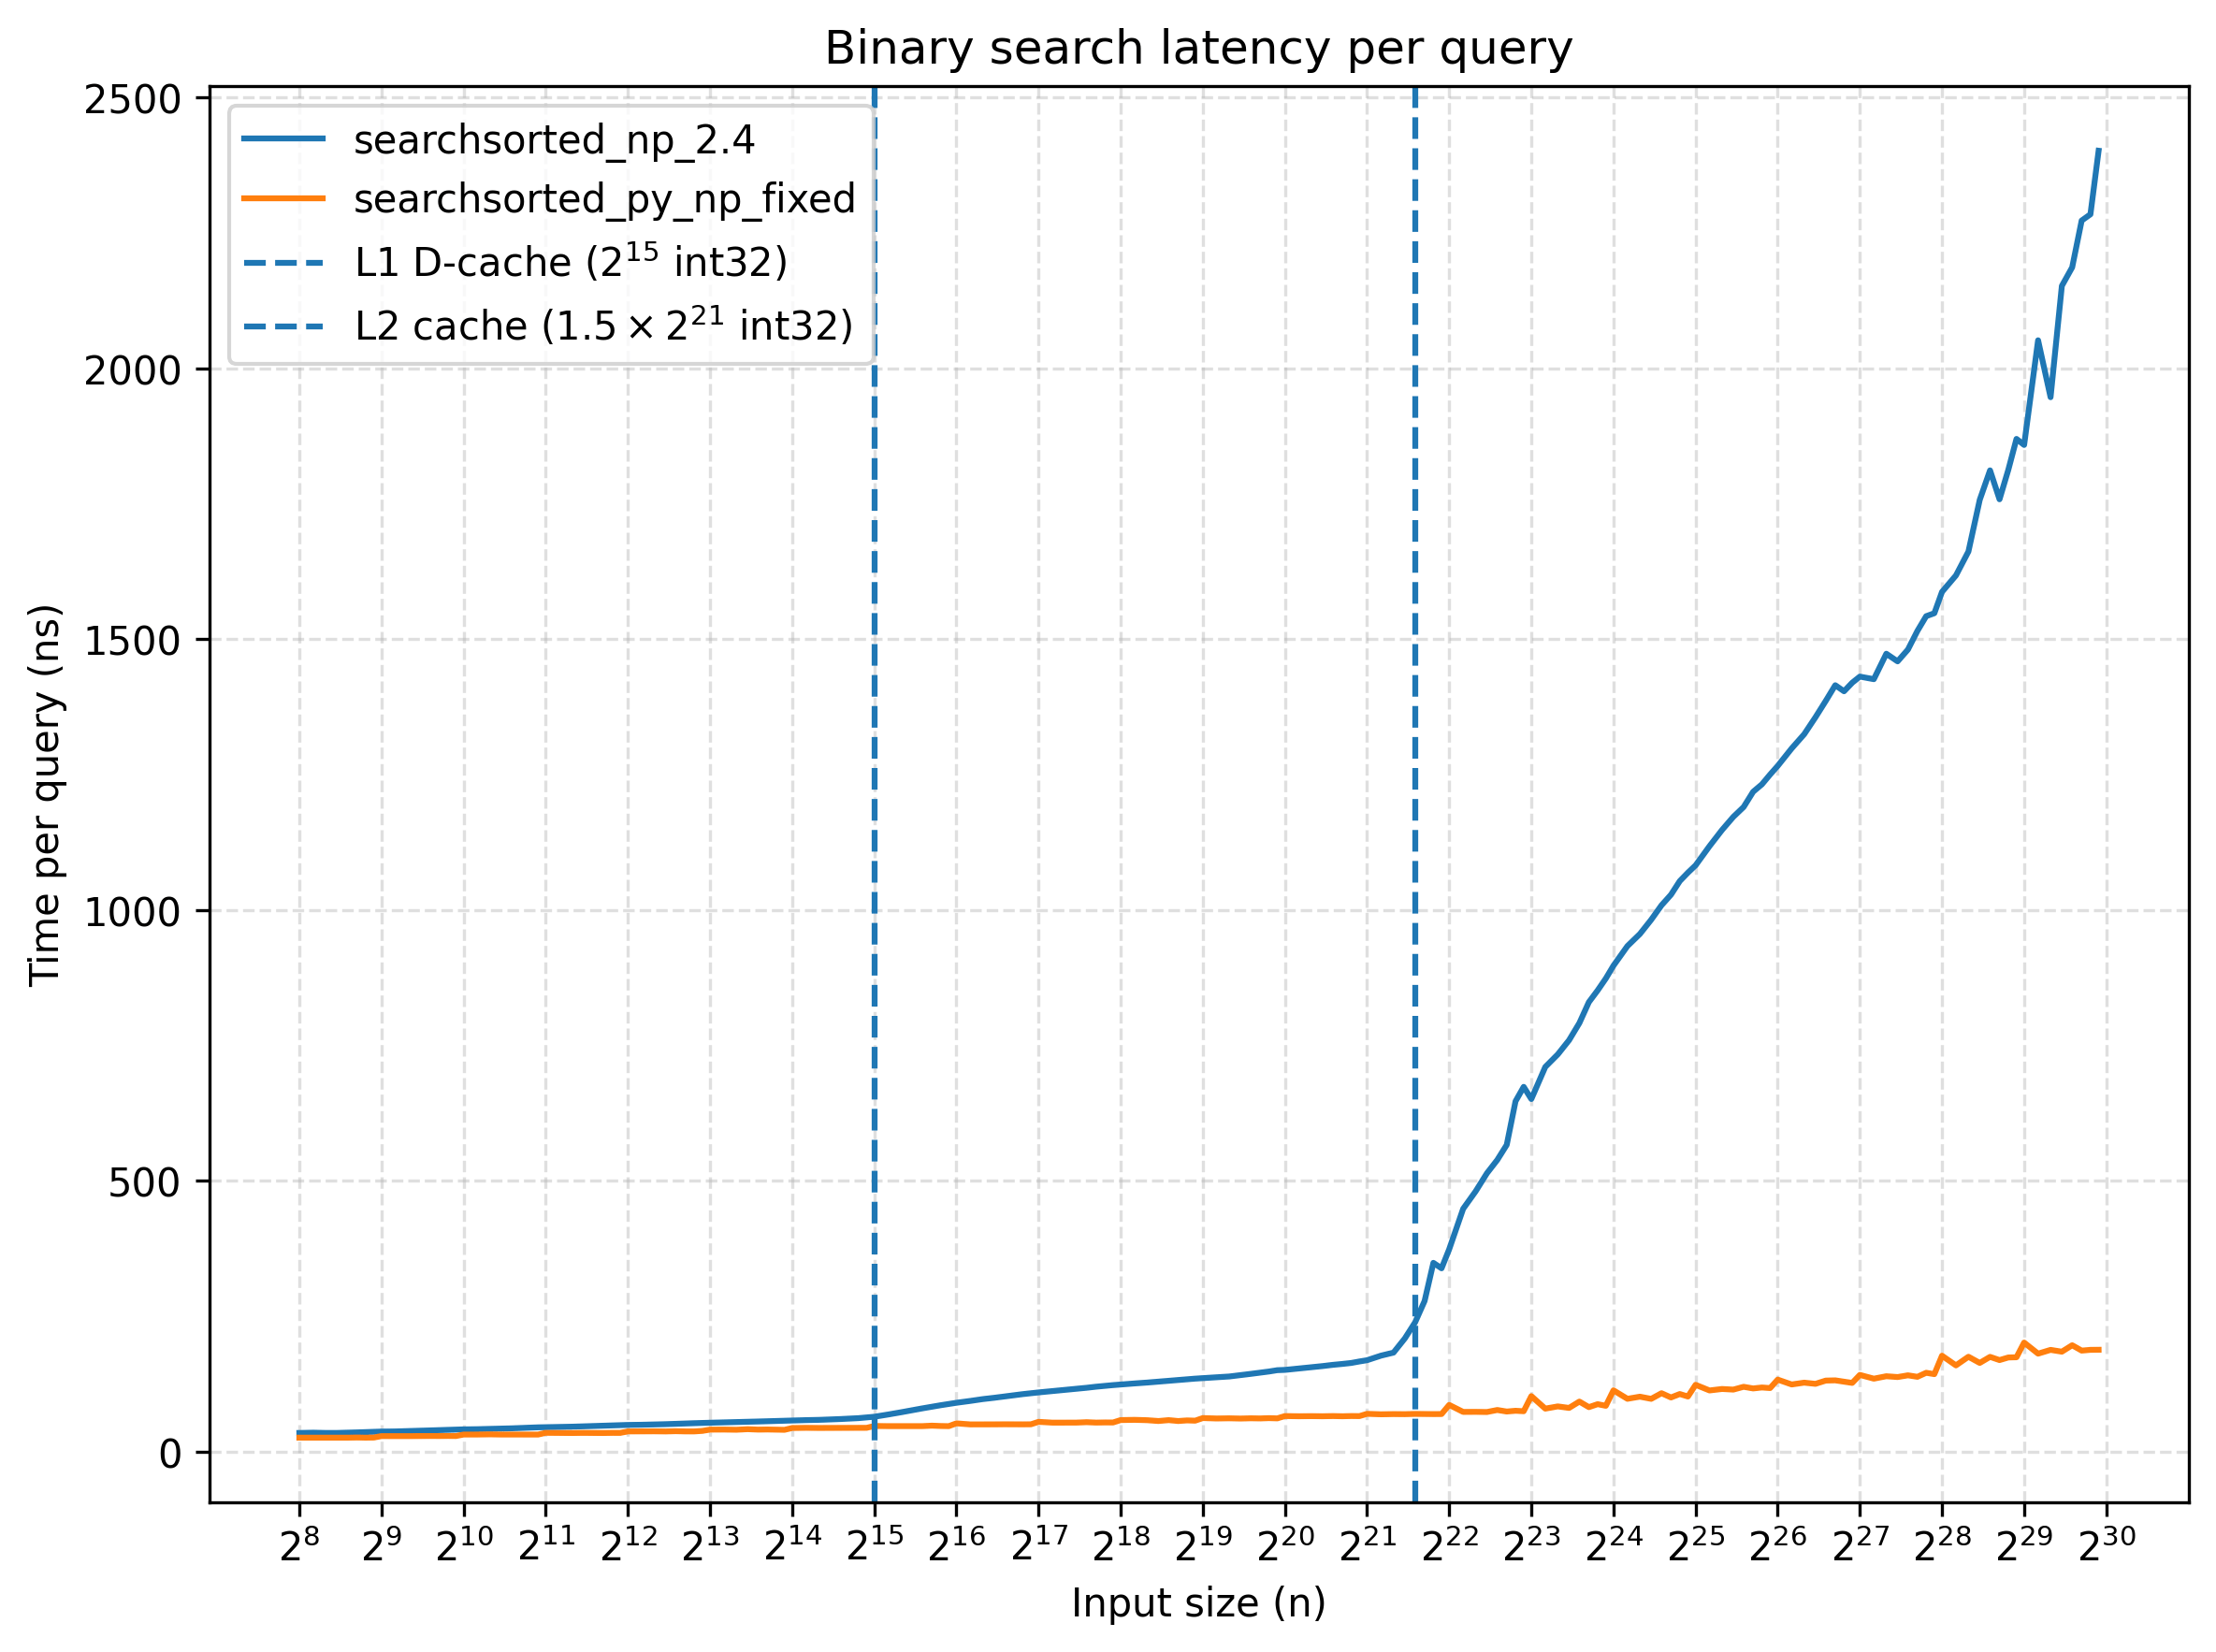
<p>Let’s compare the performance of this vectorized implementation with NumPy’s native <code>searchsorted</code> (using NumPy 2.4).</p>
<p><img src="/numpy/searchsorted/images/figure4-fs8.png" alt=""></p>
<p>Our vectorized Python implementation can be an order of magnitude faster than the native one for inputs with several keys. To understand why, let&rsquo;s take a look at <code>NumPy 2.4</code> implementation:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">template</span> <span class="o">&lt;</span><span class="k">class</span> <span class="nc">Tag</span><span class="p">,</span> <span class="n">side_t</span> <span class="n">side</span><span class="o">&gt;</span>
</span></span><span class="line"><span class="cl"><span class="k">static</span> <span class="kt">void</span>
</span></span><span class="line"><span class="cl"><span class="n">binsearch</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span> <span class="o">*</span><span class="n">arr</span><span class="p">,</span> <span class="k">const</span> <span class="kt">char</span> <span class="o">*</span><span class="n">key</span><span class="p">,</span> <span class="kt">char</span> <span class="o">*</span><span class="n">ret</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">arr_len</span><span class="p">,</span>
</span></span><span class="line"><span class="cl">          <span class="n">npy_intp</span> <span class="n">key_len</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">arr_str</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">key_str</span><span class="p">,</span>
</span></span><span class="line"><span class="cl">          <span class="n">npy_intp</span> <span class="n">ret_str</span><span class="p">,</span> <span class="n">PyArrayObject</span> <span class="o">*</span><span class="p">)</span>
</span></span><span class="line"><span class="cl"><span class="p">{</span>
</span></span><span class="line"><span class="cl">    <span class="k">using</span> <span class="n">T</span> <span class="o">=</span> <span class="k">typename</span> <span class="n">Tag</span><span class="o">::</span><span class="n">type</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="k">auto</span> <span class="n">cmp</span> <span class="o">=</span> <span class="n">side_to_cmp</span><span class="o">&lt;</span><span class="n">Tag</span><span class="p">,</span> <span class="n">side</span><span class="o">&gt;::</span><span class="n">value</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="n">npy_intp</span> <span class="n">min_idx</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="n">npy_intp</span> <span class="n">max_idx</span> <span class="o">=</span> <span class="n">arr_len</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="n">T</span> <span class="n">last_key_val</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">if</span> <span class="p">(</span><span class="n">key_len</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="k">return</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl">    <span class="n">last_key_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)</span><span class="n">key</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">for</span> <span class="p">(;</span> <span class="n">key_len</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">;</span> <span class="n">key_len</span><span class="o">--</span><span class="p">,</span> <span class="n">key</span> <span class="o">+=</span> <span class="n">key_str</span><span class="p">,</span> <span class="n">ret</span> <span class="o">+=</span> <span class="n">ret_str</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="k">const</span> <span class="n">T</span> <span class="n">key_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)</span><span class="n">key</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="cm">/*
</span></span></span><span class="line"><span class="cl"><span class="cm">         * Updating only one of the indices based on the previous key
</span></span></span><span class="line"><span class="cl"><span class="cm">         * gives the search a big boost when keys are sorted, but slightly
</span></span></span><span class="line"><span class="cl"><span class="cm">         * slows down things for purely random ones.
</span></span></span><span class="line"><span class="cl"><span class="cm">         */</span>
</span></span><span class="line"><span class="cl">        <span class="k">if</span> <span class="p">(</span><span class="n">cmp</span><span class="p">(</span><span class="n">last_key_val</span><span class="p">,</span> <span class="n">key_val</span><span class="p">))</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">            <span class="n">max_idx</span> <span class="o">=</span> <span class="n">arr_len</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="p">}</span>
</span></span><span class="line"><span class="cl">        <span class="k">else</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">            <span class="n">min_idx</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">            <span class="n">max_idx</span> <span class="o">=</span> <span class="p">(</span><span class="n">max_idx</span> <span class="o">&lt;</span> <span class="n">arr_len</span><span class="p">)</span> <span class="o">?</span> <span class="p">(</span><span class="n">max_idx</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">:</span> <span class="n">arr_len</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="p">}</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="n">last_key_val</span> <span class="o">=</span> <span class="n">key_val</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="k">while</span> <span class="p">(</span><span class="n">min_idx</span> <span class="o">&lt;</span> <span class="n">max_idx</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">            <span class="k">const</span> <span class="n">npy_intp</span> <span class="n">mid_idx</span> <span class="o">=</span> <span class="n">min_idx</span> <span class="o">+</span> <span class="p">((</span><span class="n">max_idx</span> <span class="o">-</span> <span class="n">min_idx</span><span class="p">)</span> <span class="o">&gt;&gt;</span> <span class="mi">1</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">            <span class="k">const</span> <span class="n">T</span> <span class="n">mid_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">arr</span> <span class="o">+</span> <span class="n">mid_idx</span> <span class="o">*</span> <span class="n">arr_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">            <span class="k">if</span> <span class="p">(</span><span class="n">cmp</span><span class="p">(</span><span class="n">mid_val</span><span class="p">,</span> <span class="n">key_val</span><span class="p">))</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">                <span class="n">min_idx</span> <span class="o">=</span> <span class="n">mid_idx</span> <span class="o">+</span> <span class="mi">1</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">            <span class="p">}</span>
</span></span><span class="line"><span class="cl">            <span class="k">else</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">                <span class="n">max_idx</span> <span class="o">=</span> <span class="n">mid_idx</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">            <span class="p">}</span>
</span></span><span class="line"><span class="cl">        <span class="p">}</span>
</span></span><span class="line"><span class="cl">        <span class="o">*</span><span class="p">(</span><span class="n">npy_intp</span> <span class="o">*</span><span class="p">)</span><span class="n">ret</span> <span class="o">=</span> <span class="n">min_idx</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl"><span class="p">}</span></span></span></code></pre>
</div>
<p>Ignoring the pointer arithmetic details, the core algorithm is a classic binary search executed independently for each key. There is also an optimization that reuses previous search bounds when the input keys are sorted.</p>
<p>This implementation performs one binary search per key, where each search is a fully sequential process. Each iteration of the binary search depends on the result of the previous one (the midpoint determines which part of the array is inspected next). This creates a dependency chain within each search: the next memory access depends on the result of the previous comparison.</p>
<p>For large arrays, binary-search reads also tend to be cache-unfriendly, since each step may require a read from a different cache line. Cache misses have a greater impact on the sequential implementation because each step may stall waiting for the previous memory access to complete.</p>
<p>The vectorized implementation performs the same logical step across all queries at once (all queries advance at each step together). <strong>With multiple independent searches, the CPU can have several memory accesses in flight at once.</strong> This aligns with the observed running time once the array size exceeds the L1 and L2 cache sizes.</p>
<h3 id="can-we-optimize-numpy">Can we optimize NumPy?<a class="headerlink" href="#can-we-optimize-numpy" title="Link to this heading">#</a></h3>
<p>The previous vectorized implementation maintains two arrays, <code>lo</code> and <code>hi</code>, to represent the search interval for each query. If we were to port this exact implementation into NumPy natively, it would require using $O(K)$ additional memory where <code>K</code> is the number of queries. Even though this approach is potentially faster, this is unacceptable for memory-sensitive workloads.</p>
<p>To reduce the state required, we can reformulate binary search in terms of interval boundaries. Instead of tracking both <code>lo</code> and <code>hi</code> for each query, we describe each interval using its left boundary and its length.</p>
<p>The key observation is that if we structure the algorithm so that all queries shrink their intervals by the same amount at each iteration, then every interval has the same length at each iteration. This means we do not need to store a separate <code>hi</code> per query: it can be reconstructed from a single array <code>lo</code> and a global length. Note that this still needs $O(K)$ space for the output, but it requires only $O(1)$ memory beyond that output.</p>
<p>This gives us the following Python implementation:</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">def</span> <span class="nf">searchsorted_py_np_fast_where</span><span class="p">(</span><span class="n">arr</span><span class="p">,</span> <span class="n">keys</span><span class="p">):</span>
</span></span><span class="line"><span class="cl">    <span class="n">K</span> <span class="o">=</span> <span class="n">keys</span><span class="o">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
</span></span><span class="line"><span class="cl">    <span class="n">length</span> <span class="o">=</span> <span class="n">arr</span><span class="o">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="n">base</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">K</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="o">.</span><span class="n">intp</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="c1"># Invariant: the insertion index lies in [base, base + length]</span>
</span></span><span class="line"><span class="cl">    <span class="k">while</span> <span class="n">length</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">:</span>
</span></span><span class="line"><span class="cl">        <span class="n">half</span> <span class="o">=</span> <span class="n">length</span> <span class="o">&gt;&gt;</span> <span class="mi">1</span>
</span></span><span class="line"><span class="cl">        <span class="n">mid</span> <span class="o">=</span> <span class="n">base</span> <span class="o">+</span> <span class="n">half</span>
</span></span><span class="line"><span class="cl">        <span class="n">base</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">keys</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="p">[</span><span class="n">mid</span><span class="p">],</span> <span class="n">mid</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">        <span class="n">length</span> <span class="o">-=</span> <span class="n">half</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="c1"># Final step: result is either base and base + 1</span>
</span></span><span class="line"><span class="cl">    <span class="n">base</span> <span class="o">=</span> <span class="n">np</span><span class="o">.</span><span class="n">where</span><span class="p">(</span><span class="n">keys</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="p">[</span><span class="n">base</span><span class="p">],</span> <span class="n">base</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">return</span> <span class="n">base</span></span></span></code></pre>
</div>
<p>Only a single array <code>base</code> is needed to store the per-query state, while length is shared across all queries. The output is written directly into base, so no additional state array is required. This implementation still requires allocating a temporary <code>mid</code> to hold the midpoints, but this can be avoided in the C++ port.</p>
<p>This formulation is closely related to the branchless binary search approach discussed in <a href="https://en.algorithmica.org/hpc/data-structures/binary-search/#removing-branches">Algorithmica&rsquo;s case study</a>. In the formulation we use, the invariant range is <code>[base, base + length]</code>. Therefore a final step is required when <code>length = 1</code> to resolve whether the insertion point falls to the left or right of <code>base</code>.</p>
<p>The reformulated implementation is significantly faster:</p>
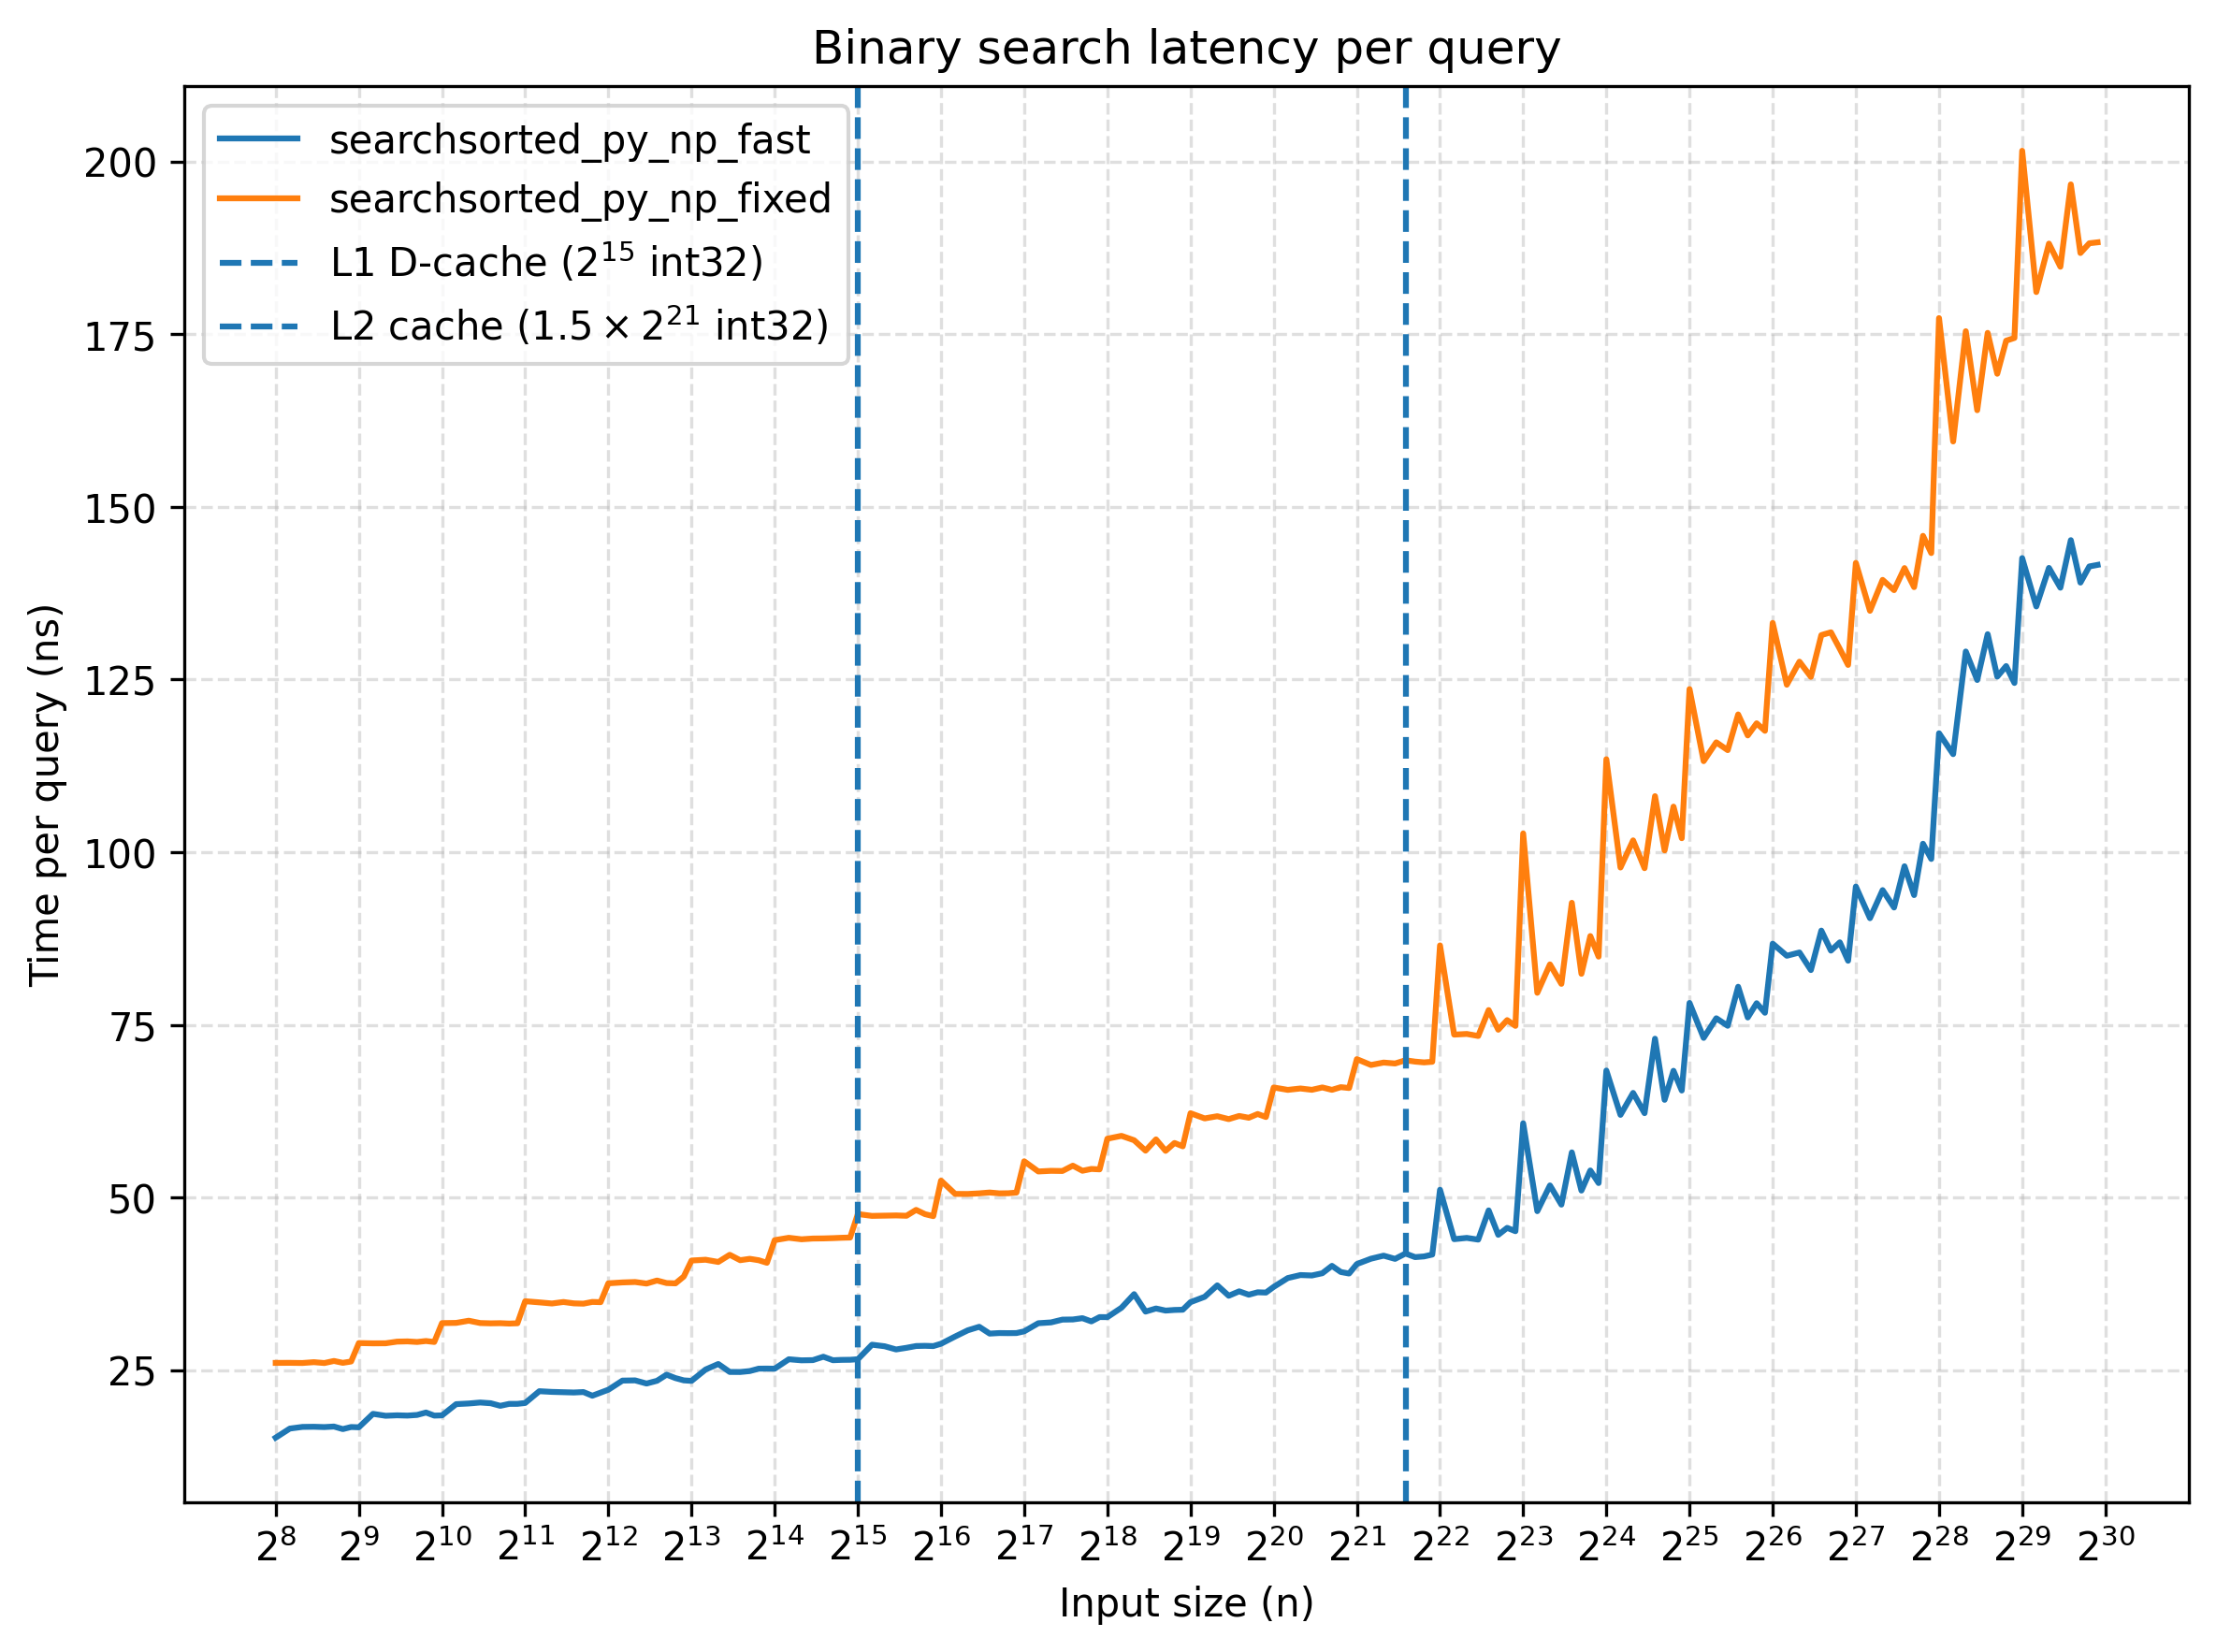
<p><img src="/numpy/searchsorted/images/figure6-fs8.png" alt=""></p>
<h3 id="porting-it-into-c">Porting it into C++<a class="headerlink" href="#porting-it-into-c" title="Link to this heading">#</a></h3>
<p>The performance results show the benefit of reducing the per-query state. We can now translate it almost directly to C++ with $O(1)$ additional memory.</p>


<div class="highlight">
  <pre class="chroma"><code><span class="line"><span class="cl"><span class="k">template</span> <span class="o">&lt;</span><span class="k">class</span> <span class="nc">Tag</span><span class="p">,</span> <span class="n">side_t</span> <span class="n">side</span><span class="o">&gt;</span>
</span></span><span class="line"><span class="cl"><span class="k">static</span> <span class="kt">void</span>
</span></span><span class="line"><span class="cl"><span class="n">binsearch</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span> <span class="o">*</span><span class="n">arr</span><span class="p">,</span> <span class="k">const</span> <span class="kt">char</span> <span class="o">*</span><span class="n">key</span><span class="p">,</span> <span class="kt">char</span> <span class="o">*</span><span class="n">ret</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">arr_len</span><span class="p">,</span>
</span></span><span class="line"><span class="cl">          <span class="n">npy_intp</span> <span class="n">key_len</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">arr_str</span><span class="p">,</span> <span class="n">npy_intp</span> <span class="n">key_str</span><span class="p">,</span>
</span></span><span class="line"><span class="cl">          <span class="n">npy_intp</span> <span class="n">ret_str</span><span class="p">,</span> <span class="n">PyArrayObject</span> <span class="o">*</span><span class="p">)</span>
</span></span><span class="line"><span class="cl"><span class="p">{</span>
</span></span><span class="line"><span class="cl">    <span class="k">using</span> <span class="n">T</span> <span class="o">=</span> <span class="k">typename</span> <span class="n">Tag</span><span class="o">::</span><span class="n">type</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="k">auto</span> <span class="n">cmp</span> <span class="o">=</span> <span class="n">side_to_cmp</span><span class="o">&lt;</span><span class="n">Tag</span><span class="p">,</span> <span class="n">side</span><span class="o">&gt;::</span><span class="n">value</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="c1">// If the array length is 0 we return all 0s
</span></span></span><span class="line"><span class="cl"><span class="c1"></span>    <span class="k">if</span> <span class="p">(</span><span class="n">arr_len</span> <span class="o">&lt;=</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="k">for</span> <span class="p">(</span><span class="n">npy_intp</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">key_len</span><span class="p">;</span> <span class="o">++</span><span class="n">i</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">            <span class="o">*</span><span class="p">(</span><span class="n">npy_intp</span> <span class="o">*</span><span class="p">)(</span><span class="n">ret</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">ret_str</span><span class="p">)</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="p">}</span>
</span></span><span class="line"><span class="cl">        <span class="k">return</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="cm">/*
</span></span></span><span class="line"><span class="cl"><span class="cm">    base = np.zeros(K, dtype=np.intp)
</span></span></span><span class="line"><span class="cl"><span class="cm">
</span></span></span><span class="line"><span class="cl"><span class="cm">    We unroll the first iteration for the following reasons:
</span></span></span><span class="line"><span class="cl"><span class="cm">        1. ret is not initialized with the bases, so we save |keys| writes
</span></span></span><span class="line"><span class="cl"><span class="cm">        by not having to initialize it with 0s.
</span></span></span><span class="line"><span class="cl"><span class="cm">        2. By assuming the initial base for every key is 0, we also save
</span></span></span><span class="line"><span class="cl"><span class="cm">        |keys| reads.
</span></span></span><span class="line"><span class="cl"><span class="cm">        3. In the first iteration, all elements are compared against the
</span></span></span><span class="line"><span class="cl"><span class="cm">        median. So we can store it in a variable and use it for all keys.
</span></span></span><span class="line"><span class="cl"><span class="cm">
</span></span></span><span class="line"><span class="cl"><span class="cm">    This initial block replaces the initialization loop that is used for the
</span></span></span><span class="line"><span class="cl"><span class="cm">    arr_len==0 case. Note that when arr_len = 1, then half is 0 so the
</span></span></span><span class="line"><span class="cl"><span class="cm">    following block initializes the array as with 0s.
</span></span></span><span class="line"><span class="cl"><span class="cm">    */</span>
</span></span><span class="line"><span class="cl">    <span class="n">npy_intp</span> <span class="n">interval_length</span> <span class="o">=</span> <span class="n">arr_len</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="n">npy_intp</span> <span class="n">half</span> <span class="o">=</span> <span class="n">interval_length</span> <span class="o">&gt;&gt;</span> <span class="mi">1</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="n">interval_length</span> <span class="o">-=</span> <span class="n">half</span><span class="p">;</span> <span class="c1">// length -&gt; ceil(length / 2)
</span></span></span><span class="line"><span class="cl"><span class="c1"></span>
</span></span><span class="line"><span class="cl">    <span class="n">npy_intp</span> <span class="n">base</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="k">const</span> <span class="n">T</span> <span class="n">mid_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">arr</span> <span class="o">+</span> <span class="p">(</span><span class="n">base</span> <span class="o">+</span> <span class="n">half</span><span class="p">)</span> <span class="o">*</span> <span class="n">arr_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="k">for</span> <span class="p">(</span><span class="n">npy_intp</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">key_len</span><span class="p">;</span> <span class="o">++</span><span class="n">i</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="k">const</span> <span class="n">T</span> <span class="n">key_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">key</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">key_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">        <span class="o">*</span><span class="p">(</span><span class="n">npy_intp</span> <span class="o">*</span><span class="p">)(</span><span class="n">ret</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">ret_str</span><span class="p">)</span> <span class="o">=</span> <span class="n">cmp</span><span class="p">(</span><span class="n">mid_val</span><span class="p">,</span> <span class="n">key_val</span><span class="p">)</span> <span class="o">*</span> <span class="n">half</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="cm">/*
</span></span></span><span class="line"><span class="cl"><span class="cm">        while length &gt; 1:
</span></span></span><span class="line"><span class="cl"><span class="cm">            half = length &gt;&gt; 1
</span></span></span><span class="line"><span class="cl"><span class="cm">            length -= half
</span></span></span><span class="line"><span class="cl"><span class="cm">            mid = base + half
</span></span></span><span class="line"><span class="cl"><span class="cm">            base = np.where(keys &gt; arr[mid], mid, base)
</span></span></span><span class="line"><span class="cl"><span class="cm">    */</span>
</span></span><span class="line"><span class="cl">    <span class="k">while</span> <span class="p">(</span><span class="n">interval_length</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="n">npy_intp</span> <span class="n">half</span> <span class="o">=</span> <span class="n">interval_length</span> <span class="o">&gt;&gt;</span> <span class="mi">1</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="n">interval_length</span> <span class="o">-=</span> <span class="n">half</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">        <span class="k">for</span> <span class="p">(</span><span class="n">npy_intp</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">key_len</span><span class="p">;</span> <span class="o">++</span><span class="n">i</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">            <span class="n">npy_intp</span> <span class="o">&amp;</span><span class="n">base</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="n">npy_intp</span> <span class="o">*</span><span class="p">)(</span><span class="n">ret</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">ret_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">            <span class="k">const</span> <span class="n">T</span> <span class="n">mid_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">arr</span> <span class="o">+</span> <span class="p">(</span><span class="n">base</span> <span class="o">+</span> <span class="n">half</span><span class="p">)</span> <span class="o">*</span> <span class="n">arr_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">            <span class="k">const</span> <span class="n">T</span> <span class="n">key_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">key</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">key_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">            <span class="n">base</span> <span class="o">+=</span> <span class="n">cmp</span><span class="p">(</span><span class="n">mid_val</span><span class="p">,</span> <span class="n">key_val</span><span class="p">)</span> <span class="o">*</span> <span class="n">half</span><span class="p">;</span>
</span></span><span class="line"><span class="cl">        <span class="p">}</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl">
</span></span><span class="line"><span class="cl">    <span class="c1">// base = np.where(keys &gt; arr[base], base + 1, base)
</span></span></span><span class="line"><span class="cl"><span class="c1"></span>    <span class="k">for</span> <span class="p">(</span><span class="n">npy_intp</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">key_len</span><span class="p">;</span> <span class="o">++</span><span class="n">i</span><span class="p">)</span> <span class="p">{</span>
</span></span><span class="line"><span class="cl">        <span class="n">npy_intp</span> <span class="o">&amp;</span><span class="n">base</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="n">npy_intp</span> <span class="o">*</span><span class="p">)(</span><span class="n">ret</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">ret_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">        <span class="k">const</span> <span class="n">T</span> <span class="n">key_val</span> <span class="o">=</span> <span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">key</span> <span class="o">+</span> <span class="n">i</span> <span class="o">*</span> <span class="n">key_str</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">        <span class="n">base</span> <span class="o">+=</span> <span class="n">cmp</span><span class="p">(</span><span class="o">*</span><span class="p">(</span><span class="k">const</span> <span class="n">T</span> <span class="o">*</span><span class="p">)(</span><span class="n">arr</span> <span class="o">+</span> <span class="n">base</span> <span class="o">*</span> <span class="n">arr_str</span><span class="p">),</span> <span class="n">key_val</span><span class="p">);</span>
</span></span><span class="line"><span class="cl">    <span class="p">}</span>
</span></span><span class="line"><span class="cl"><span class="p">}</span></span></span></code></pre>
</div>
<p>Note that we exploited a property of the first iteration of the binary search. Because the initial value of every result entry is implicitly zero, we can skip writing and reading those values during the first iteration. Moreover, in the first iteration all elements are compared against the same median, so we can read its value once instead of <code>K</code> times.</p>
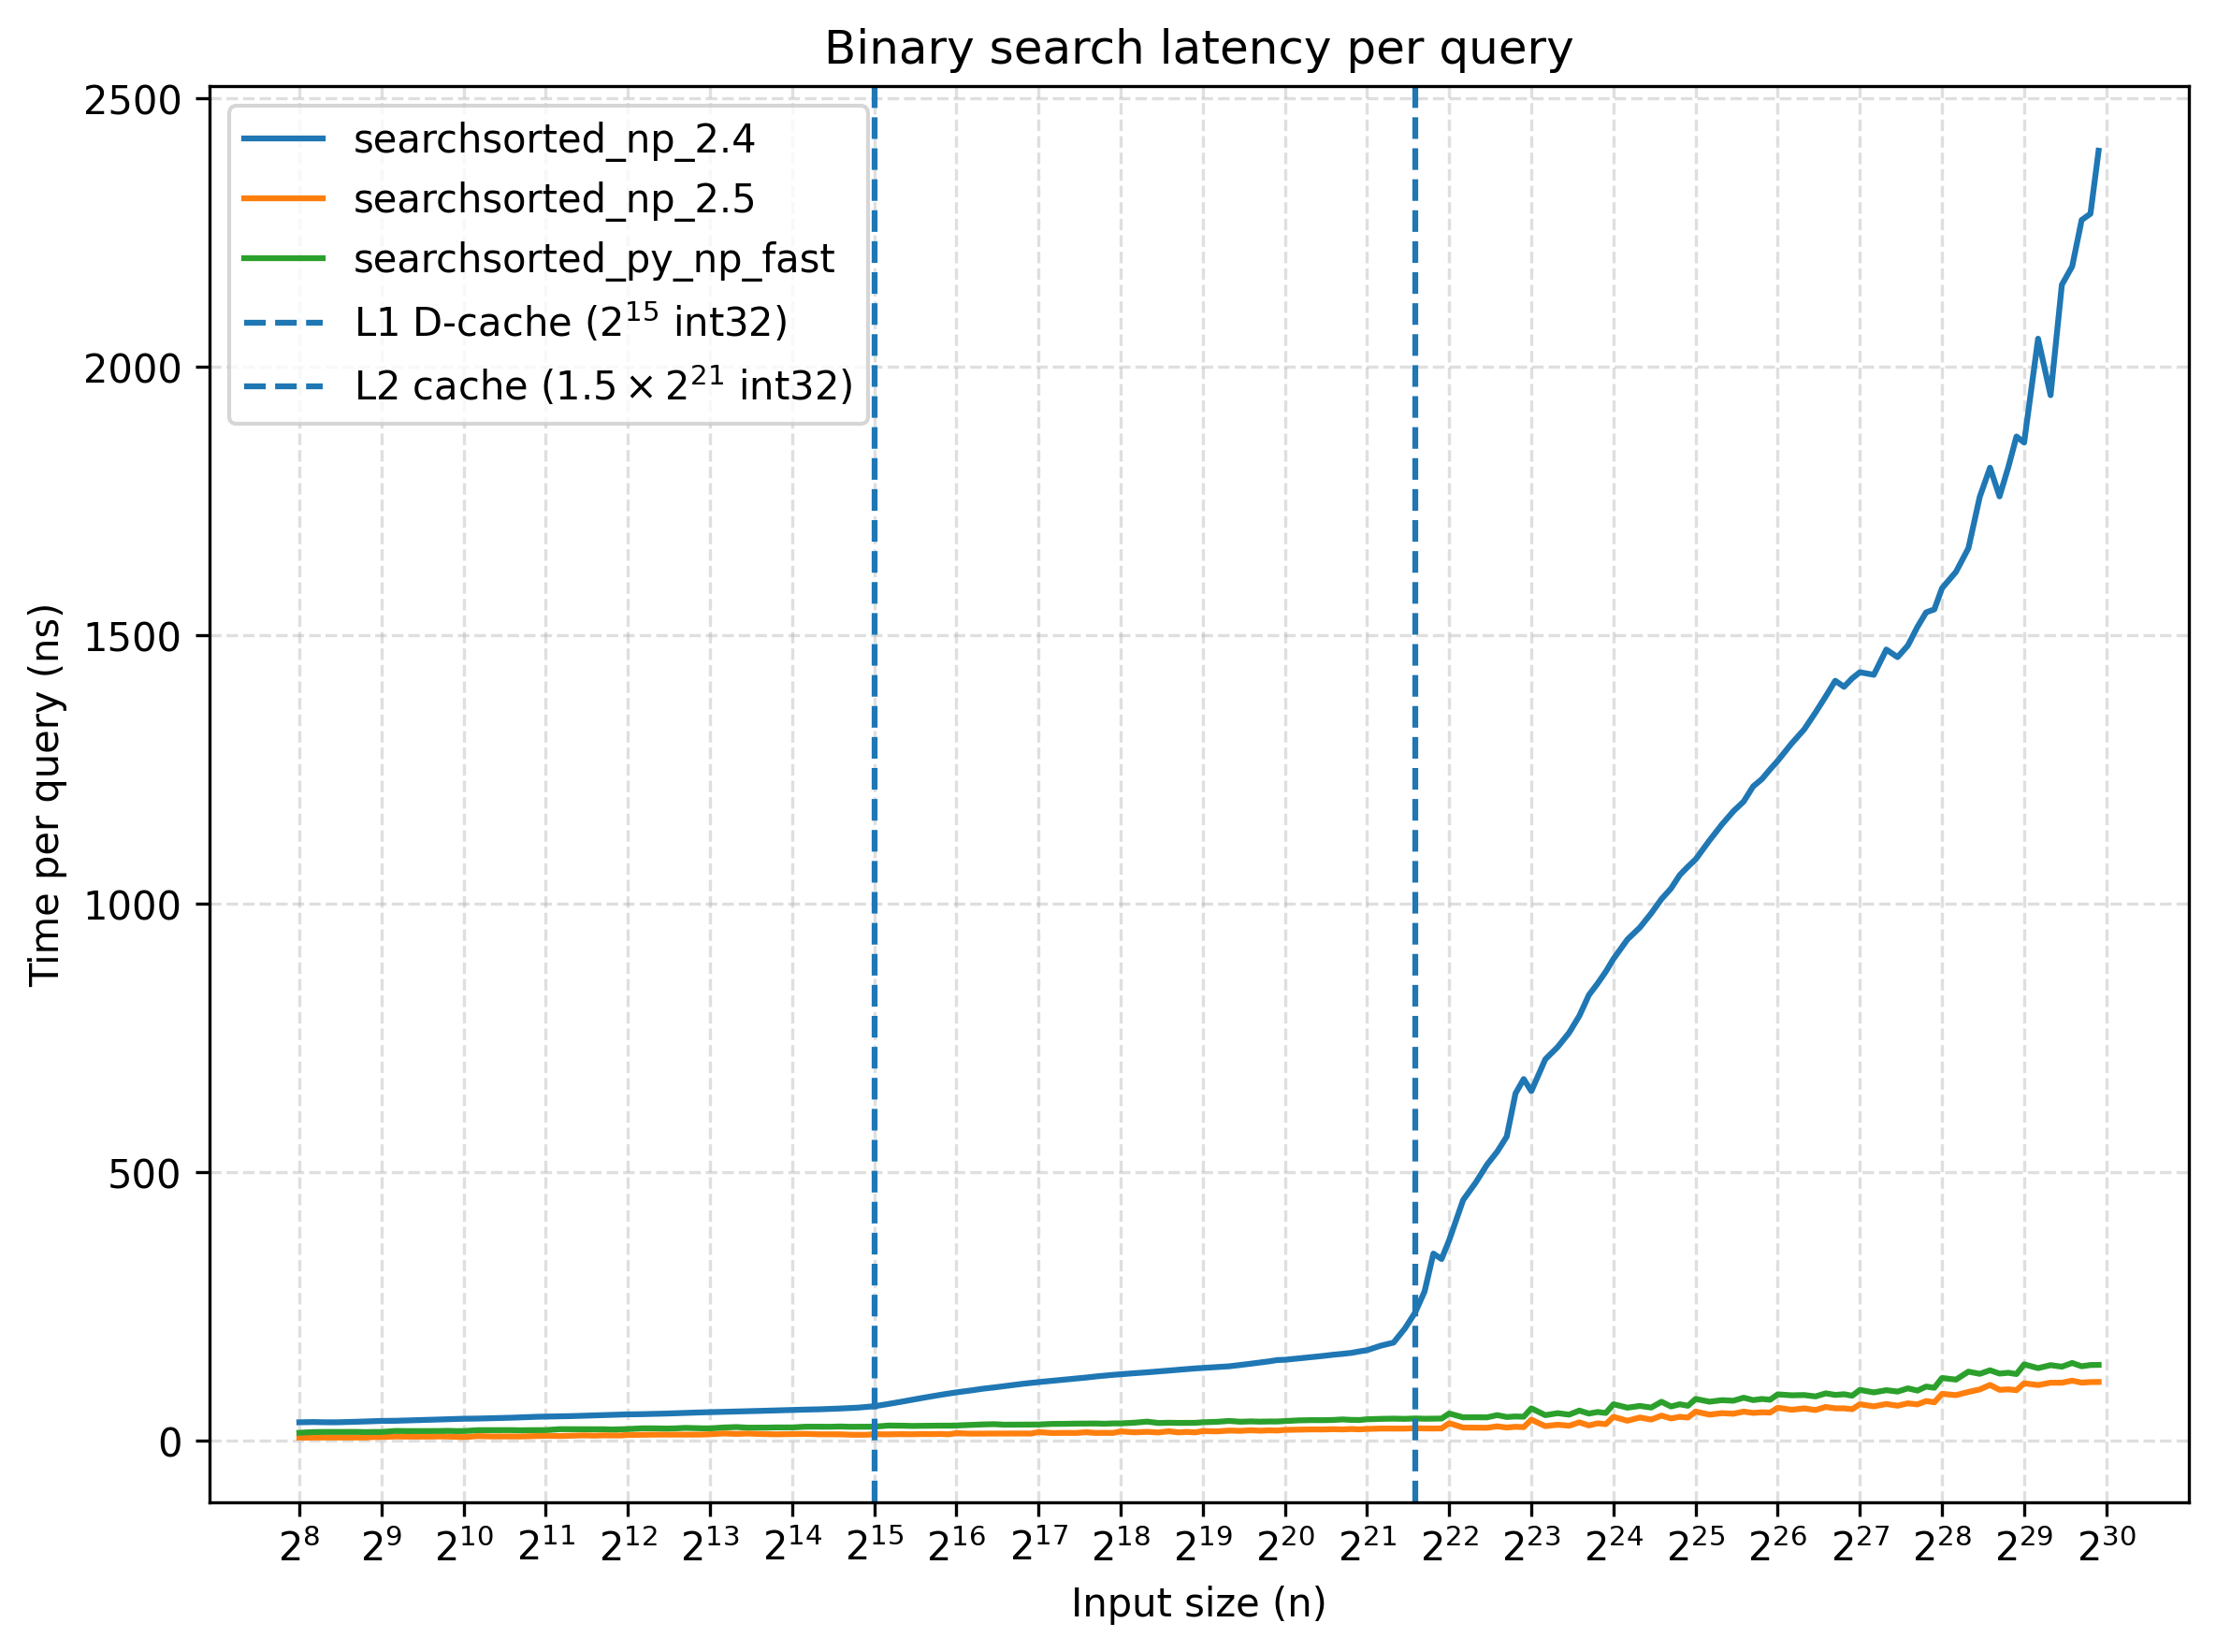
<p>This implementation was ported directly into NumPy as part of PR <a href="https://github.com/numpy/numpy/pull/30517">#30517</a>, which was included in the <a href="https://numpy.org/devdocs/release/2.5.0-notes.html#improved-performance-of-numpy-searchsorted">2.5 release</a>. Now let&rsquo;s do a final comparison between NumPy 2.4 and 2.5, and our vectorized Python implementation:</p>
<p><img src="/numpy/searchsorted/images/figure7-fs8.png" alt=""></p>
<p>The native 2.5 version is up to 25× faster than NumPy 2.4&rsquo;s implementation in our benchmarks. Compared with the vectorized Python implementation, the C++ implementation can be up to 2× as fast for smaller arrays. This difference becomes less significant as the array size grows. There is also a memory advantage over the vectorized Python implementation: the Python implementation requires additional arrays to store the search state (<code>low</code> and <code>mid</code>, or <code>base</code> and <code>base + length</code>), whereas the C++ implementation keeps length as a scalar. As a result, the C++ implementation uses only $O(1)$ additional memory, while the NumPy formulation requires memory proportional to the number of queries.</p>
<h3 id="ecosystem-comparison">Ecosystem Comparison<a class="headerlink" href="#ecosystem-comparison" title="Link to this heading">#</a></h3>
<p>We can compare our optimized NumPy 2.5 against other libraries in the ecosystem. For this experiment, we selected the Python libraries JAX, TensorFlow, and PyTorch.</p>
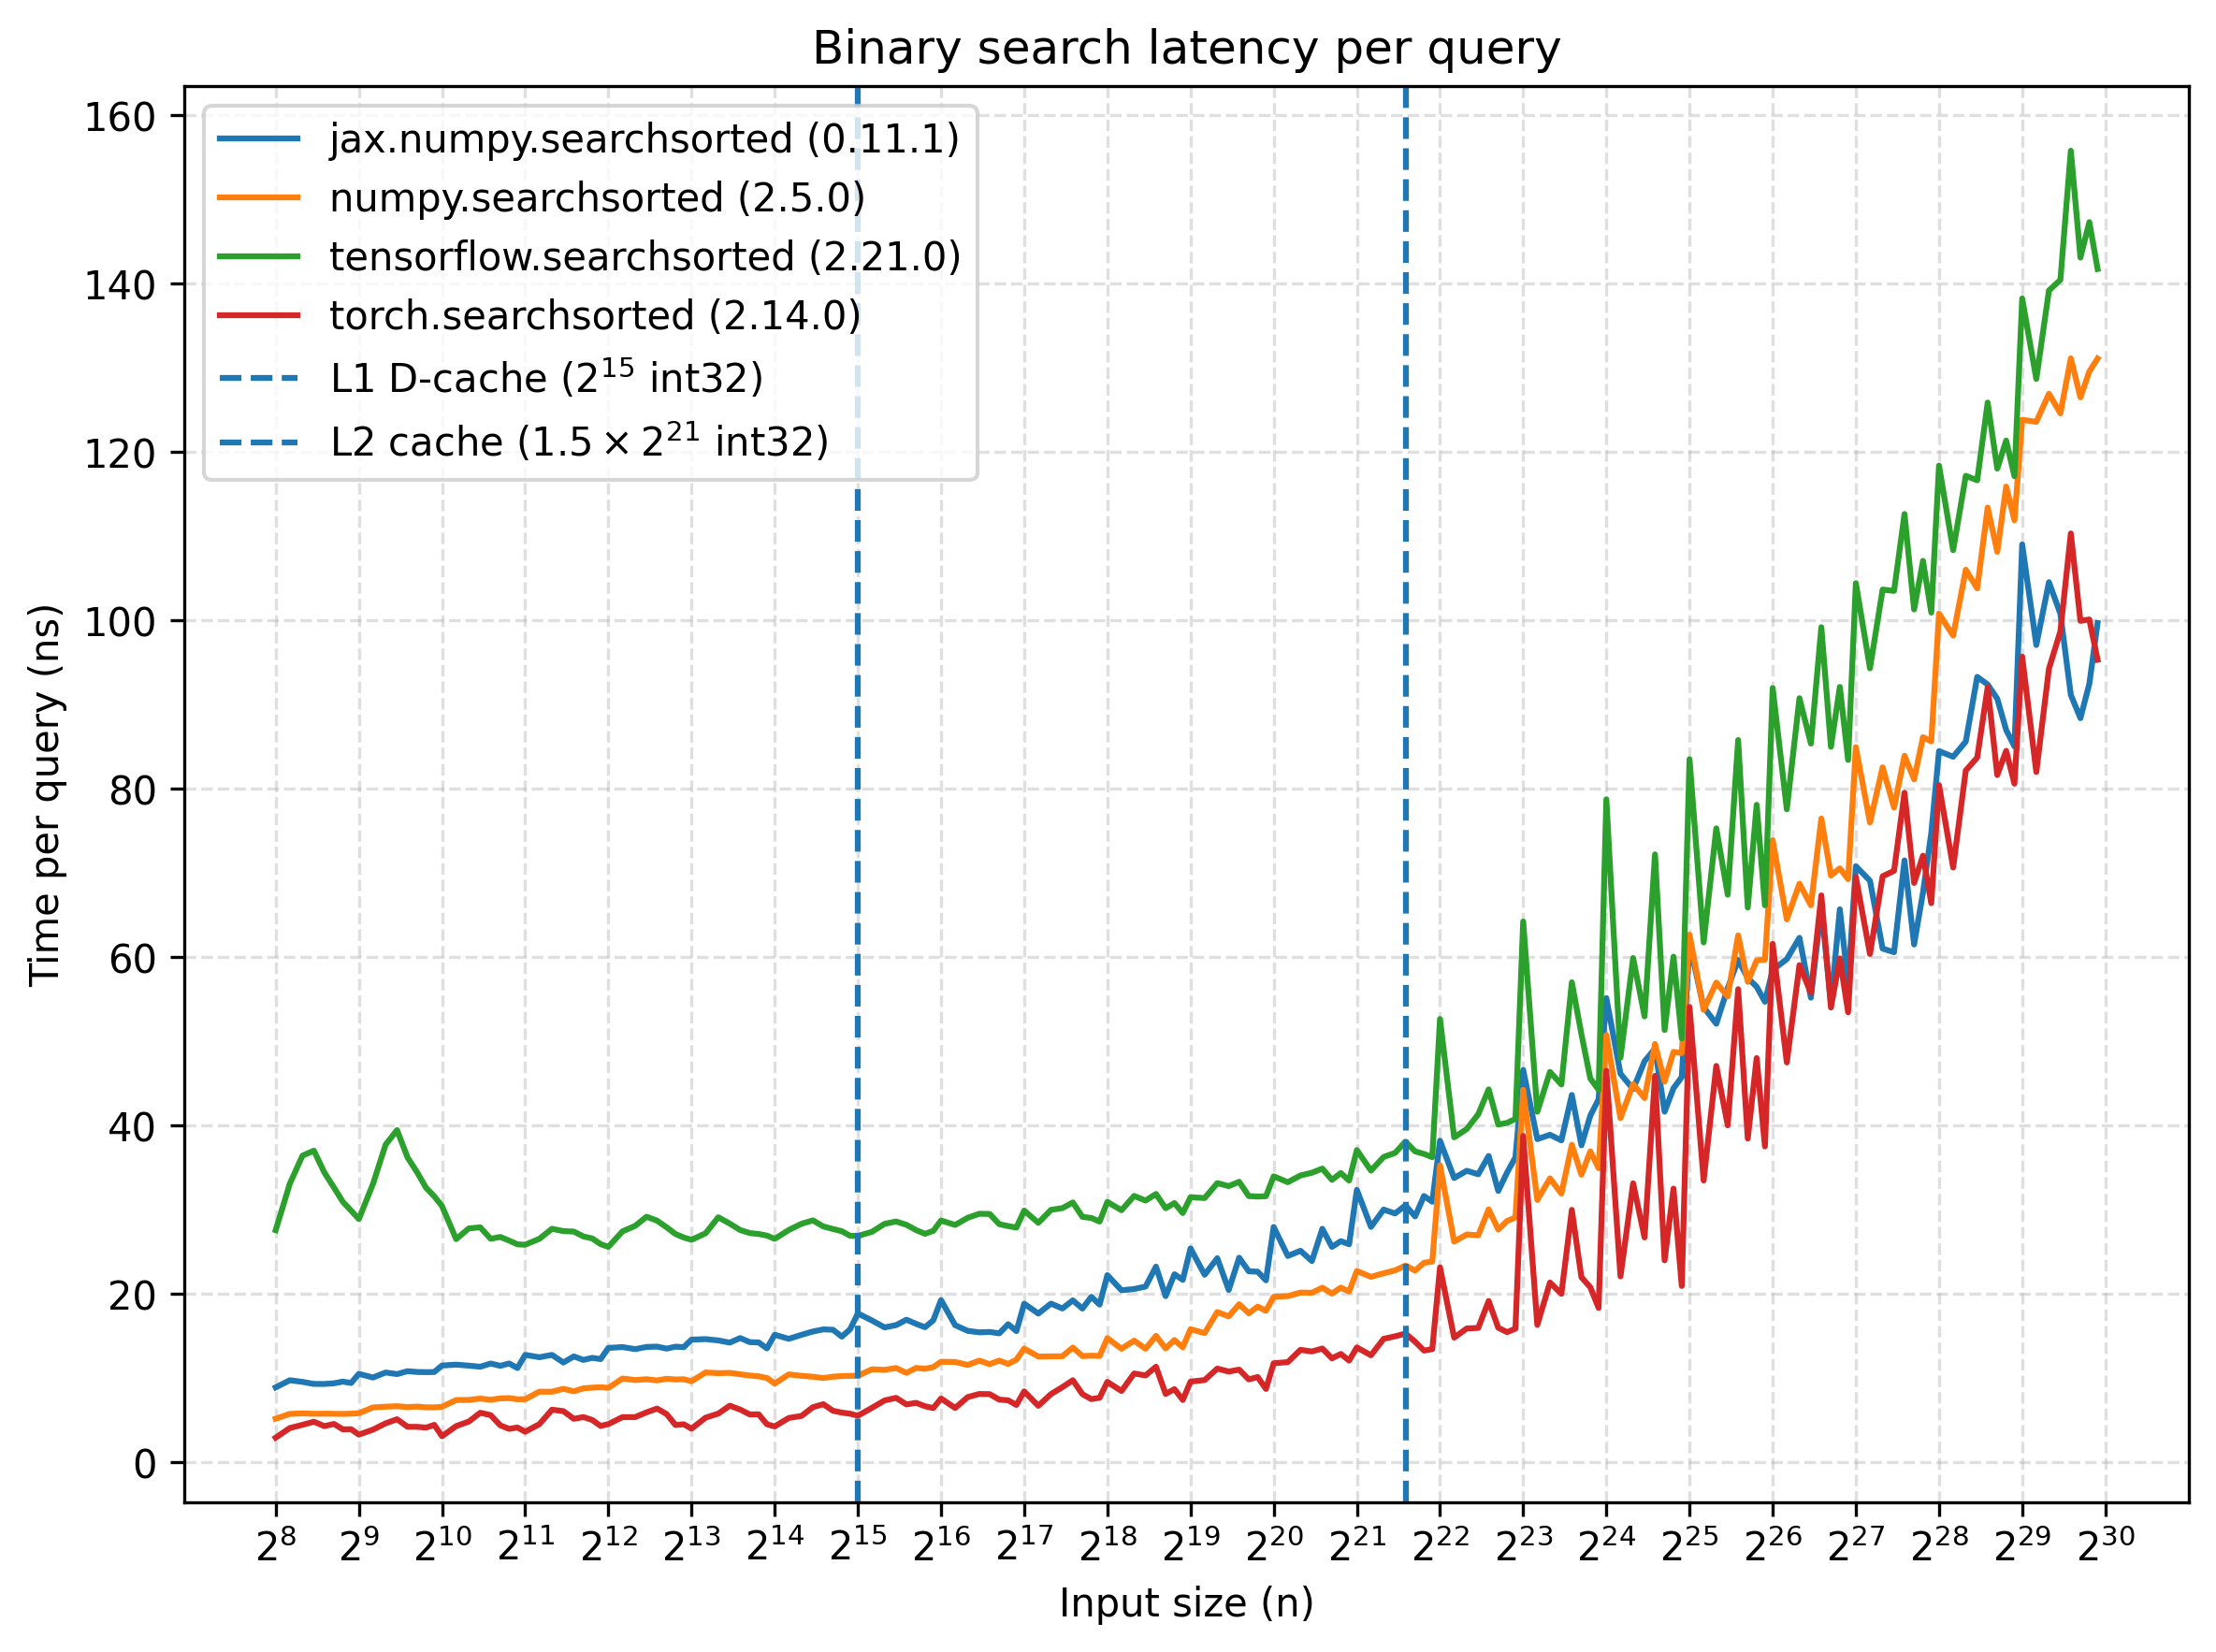
<p>TensorFlow and PyTorch follow a different approach from JAX and NumPy. While JAX and NumPy leverage vectorized/batched operations to hide memory latency, TensorFlow and PyTorch parallelize independent searches across CPU threads. Search keys are partitioned into batches that are processed by different threads. For more details, see the <a href="https://github.com/pytorch/pytorch/blob/b1bb860d3c812371b89a9725407230216e7369b5/aten/src/ATen/native/Bucketization.cpp#L88">PyTorch</a> and <a href="https://github.com/tensorflow/tensorflow/blob/bb8d3f2443d70ec8c2aae1288fbf5782c771aa60/tensorflow/core/kernels/searchsorted_op.cc#L67">TensorFlow</a> implementations.</p>
<p>In the benchmarks, we limited parallelism to 8 cores and we increased the number of query keys from 10,000 to 20,000. This gives the multithreaded implementations enough independent work to amortize thread-scheduling overhead.</p>
<p><img src="/numpy/searchsorted/images/figure8-fs8.png" alt=""></p>
<p>The benchmark shows that NumPy is competitive with the selected libraries in our benchmarks. All implementations exhibit similar behavior once the search array grows beyond the CPU cache.</p>
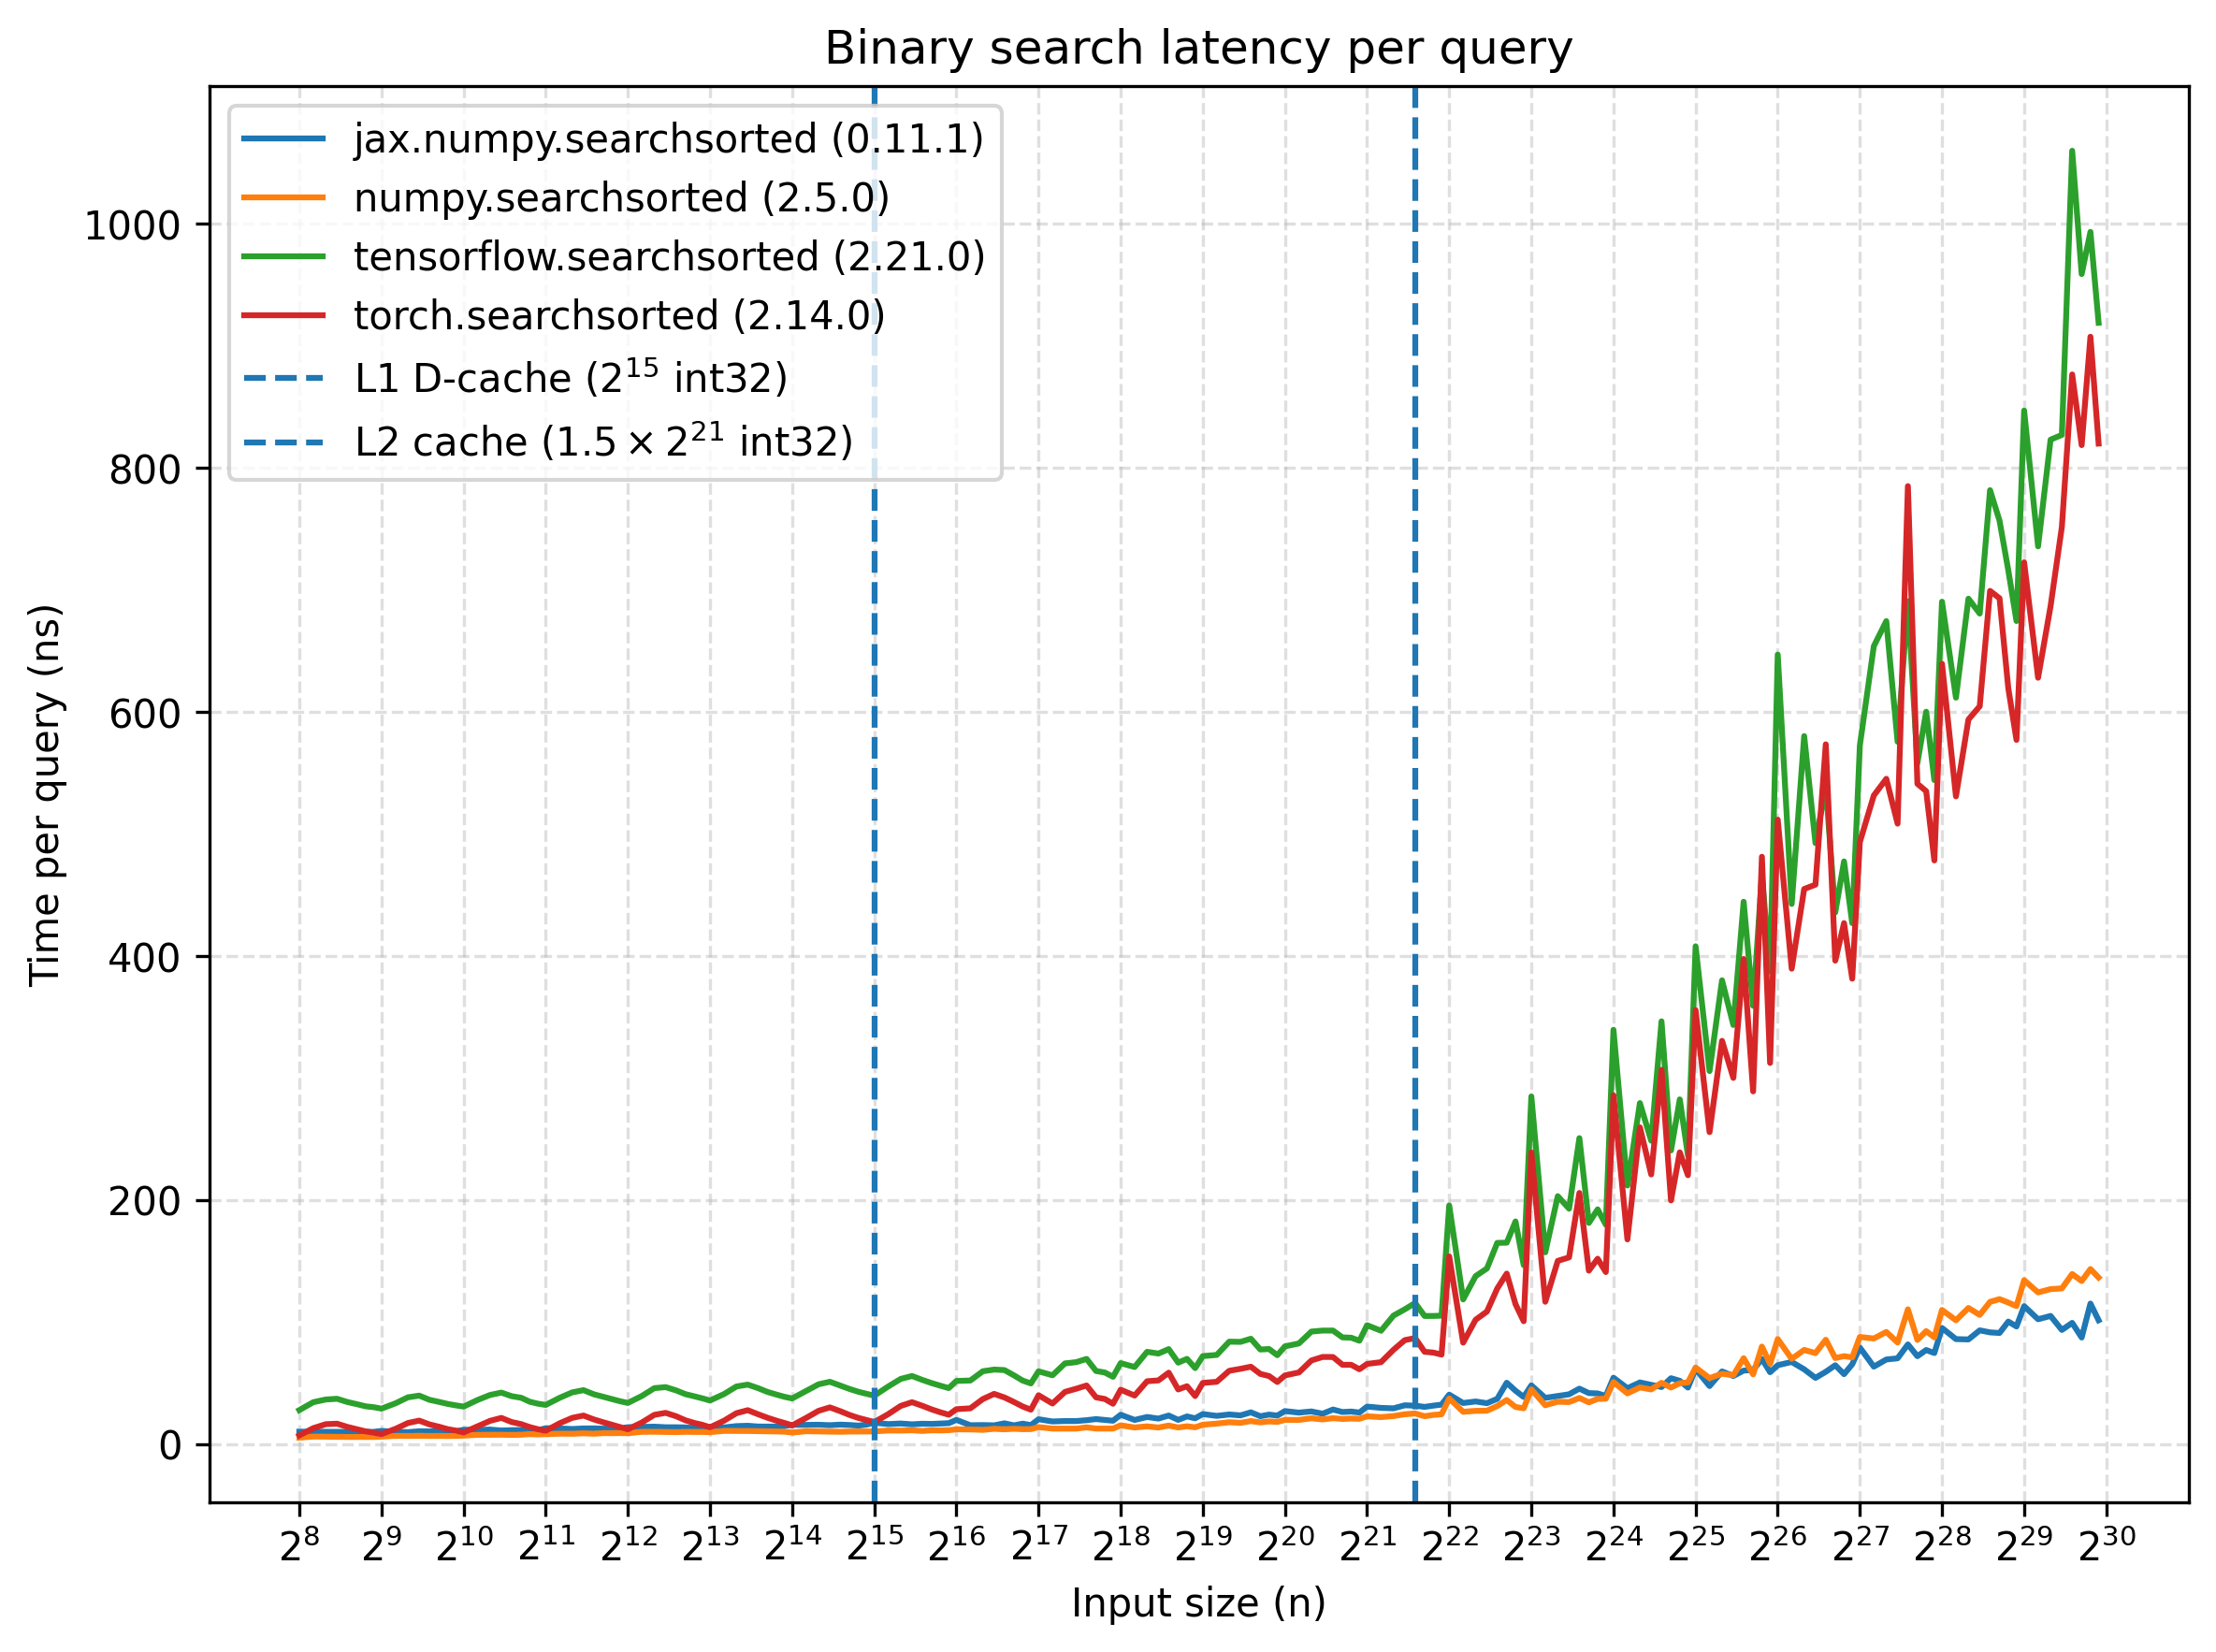
<p>If we disable multithreading, the performance of PyTorch and TensorFlow degrades, and both exhibit a similar trend to NumPy 2.4&rsquo;s implementation. Once the search array grows beyond the CPU cache, the cost of memory accesses dominates.</p>
<p><img src="/numpy/searchsorted/images/figure9-fs8.png" alt=""></p>
<p>It would be worth benchmarking whether both techniques could be combined: batching binary searches within each thread. However, once the memory subsystem becomes saturated, additional cores can compete for the same memory bandwidth. At that point, improving the memory access patterns may be a more promising direction, for example by using a different layout such as the Eytzinger layout (discussed in detail in the <a href="https://en.algorithmica.org/hpc/data-structures/binary-search/#eytzinger-layout">Algorithmica book</a>).</p>
<h3 id="conclusion">Conclusion<a class="headerlink" href="#conclusion" title="Link to this heading">#</a></h3>
<p>We made <code>np.searchsorted</code> up to 25x faster in our benchmarks. Given NumPy&rsquo;s reach in the Python ecosystem, this optimization will benefit several libraries that depend on it. Other libraries in the Python ecosystem with their own binary search implementation may also benefit from adopting similar batching techniques.</p>
<p>Interestingly, we used NumPy array primitives to derive an initial Python implementation that outperformed NumPy 2.4&rsquo;s implementation. This shows how powerful NumPy&rsquo;s array primitives can be for implementing highly performant algorithms. <strong>A vectorized NumPy implementation in Python can outperform a scalar native implementation by exploiting independent work</strong>.</p>
<p>Cache-friendly layouts such as the Eytzinger layout are another interesting direction for making <code>searchsorted</code> faster. It would be interesting to explore whether the array API could expose such layouts through an interface like <code>searchsorted(arr, keys, layout=&quot;eytzinger&quot;)</code>, although this would require carefully defining the API semantics since the Eytzinger representation is not sorted.</p>
]]></content>


                                <category scheme="taxonomy:Tags" term="numpy" label="numpy" />
                             
                                <category scheme="taxonomy:Tags" term="performance" label="performance" />
                             
                                <category scheme="taxonomy:Tags" term="binary-search" label="binary-search" />
                             
                                <category scheme="taxonomy:Tags" term="searchsorted" label="searchsorted" />


        </entry>
    
</feed>